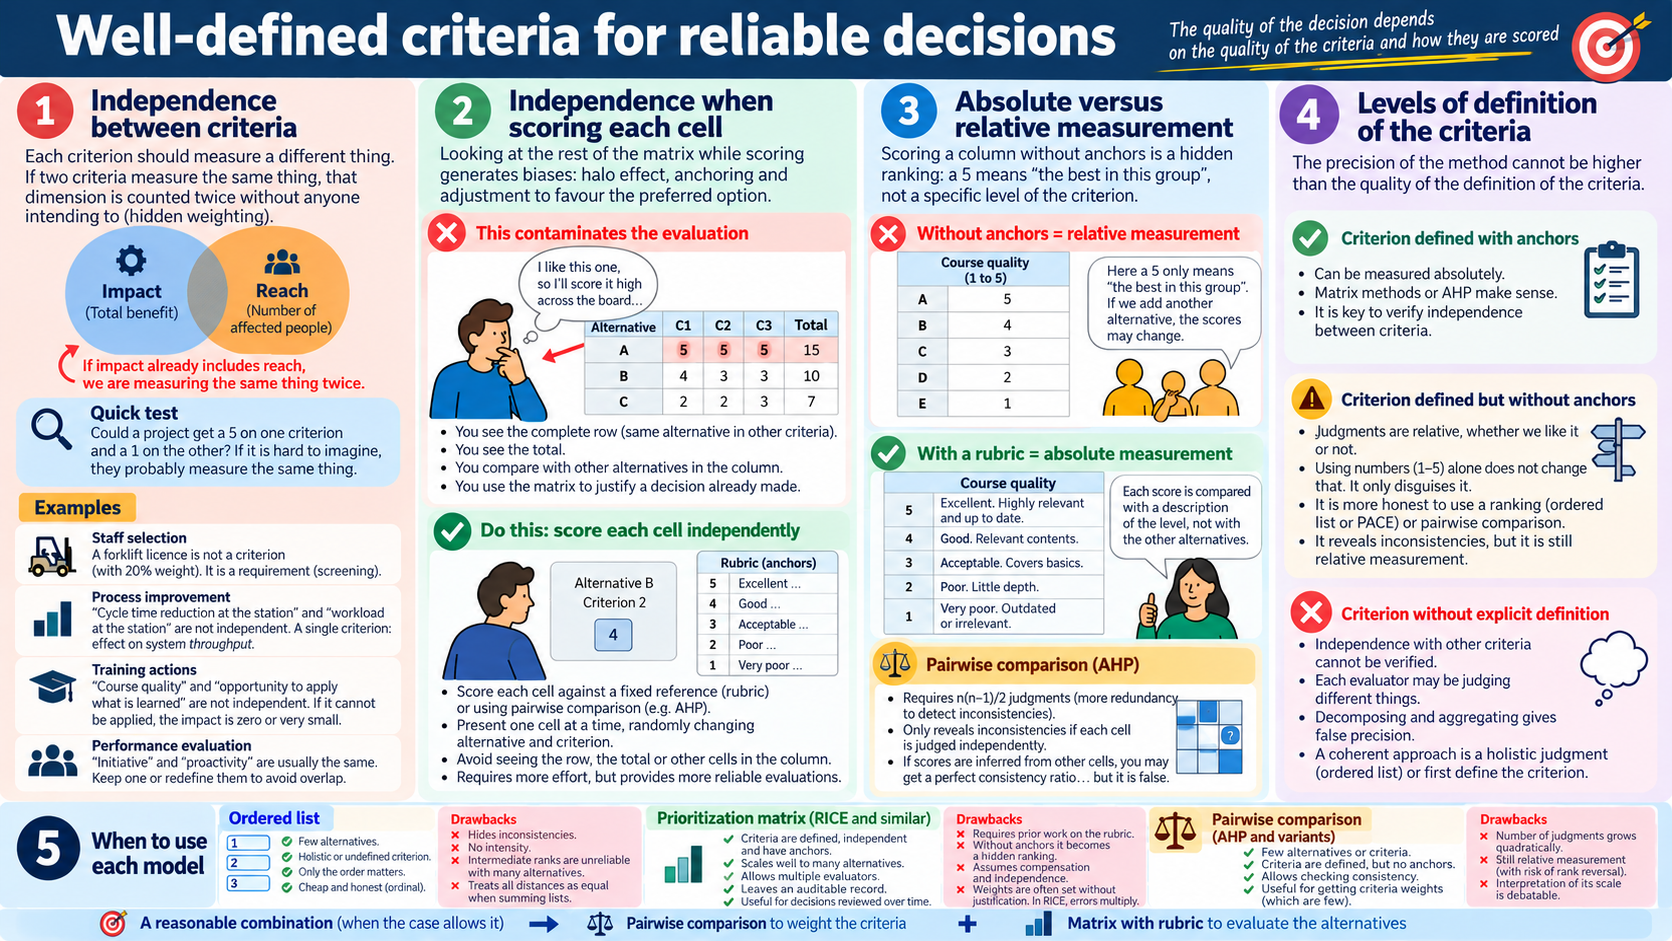
La sofisticación del método no puede superar la calidad de los criterios. Más números no hacen mejor una decisión

criterios de prioraizacion
© Juan A. Marín-García (2026) DOE-UPV-ROGLE-IEMAWith the support of the PIME/25-26/544 [Investigación acción para el diseño de los materiales, protocolo y análisis de viabilidad de una intervención compleja para analizar el impacto en la mejora del pensamiento crítico y el uso del marco de referencia del triple diamante en la toma de decisiones en grupo]. Universitat Politecnica de Valencia.

Más números, más criterios y más cálculos no implican necesariamente una decisión mejor. El rigor consiste en saber qué estamos midiendo, evitar contar dos veces lo mismo, mantener independientes los juicios y utilizar un método coherente con la calidad real de la información disponible.

Errores frecuentes que hacen que una matriz de priorización parezca más rigurosa de lo que realmente es:

  • Duplicar dimensiones sin darse cuenta. Si dos criterios miden aspectos iguales o muy solapados, esa dimensión entra varias veces en la decisión. Es una ponderación oculta.

  • Cuando el valor de un criterio depende del nivel de otro, asignarles pesos separados puede no tener sentido.

  • Confundir criterios con requisitos. Hay condiciones que no deberían recibir un peso ni compensarse con otras. Si algo es imprescindible (por ejemplo, disponer de una habilitación necesaria para un puesto) debe funcionar como filtro o umbral previo, no como una columna más de la matriz.

  • Puntuar viendo la alternativa completa. Cuando el evaluador ve simultáneamente la fila, las demás puntuaciones y, sobre todo, el total, aparecen el efecto halo, el anclaje y los ajustes para que gane la alternativa preferida. La matriz deja entonces de ayudar a tomar la decisión y pasa a justificar una decisión que, consciente o inconscientemente, ya estaba tomada. La unidad de juicio debería ser cada celda, valorada de la forma más independiente posible.

  • Creer que poner números convierte un juicio relativo en una medición absoluta. Una escala 1–5 sin anclas descriptivas no significa necesariamente que “4” represente un nivel objetivo. Con frecuencia significa simplemente “mejor que estas alternativas y peor que aquellas”. Es decir, es una ordenación relativa disfrazada de medición. La medición absoluta requiere una rúbrica que describa qué significa cada nivel.

  • Usar métodos sofisticados con criterios mal definidos. Si “encaje estratégico”, “impacto” o “calidad” significan cosas diferentes para cada evaluador, hacer más cálculos no aumenta la calidad de la decisión. Puede producir justo lo contrario. Genera una falsa rigurosidad, fundamentada en la precisión matemática, que se basa en juicios imprecisos. La sofisticación del método no debería superar la calidad de la definición de los criterios.

  • Desaprovechar la redundancia de la comparación pareada. AHP y otros métodos de comparación pareada de alternativas exigen muchos más juicios precisamente porque esa redundancia permite detectar inconsistencias. Si unas comparaciones se deducen de otras para ahorrar trabajo, puede obtenerse una consistencia aparentemente perfecta, pero se ha eliminado precisamente la información que justificaba realizar las comparaciones adicionales.

  • Elegir el método por su apariencia de rigor y no por el problema de medición. Una lista ordenada puede ser la opción más adecuada cuando el juicio es holístico o los criterios están poco definidos. Una matriz de priorización tiene sentido cuando los criterios están bien definidos, son lo bastante independientes y existen anclas que permitan valorar las alternativas. La comparación pareada resulta especialmente útil cuando los criterios están definidos, pero no existen buenas anclas, y queremos hacer explícitos los juicios relativos y comprobar su coherencia.
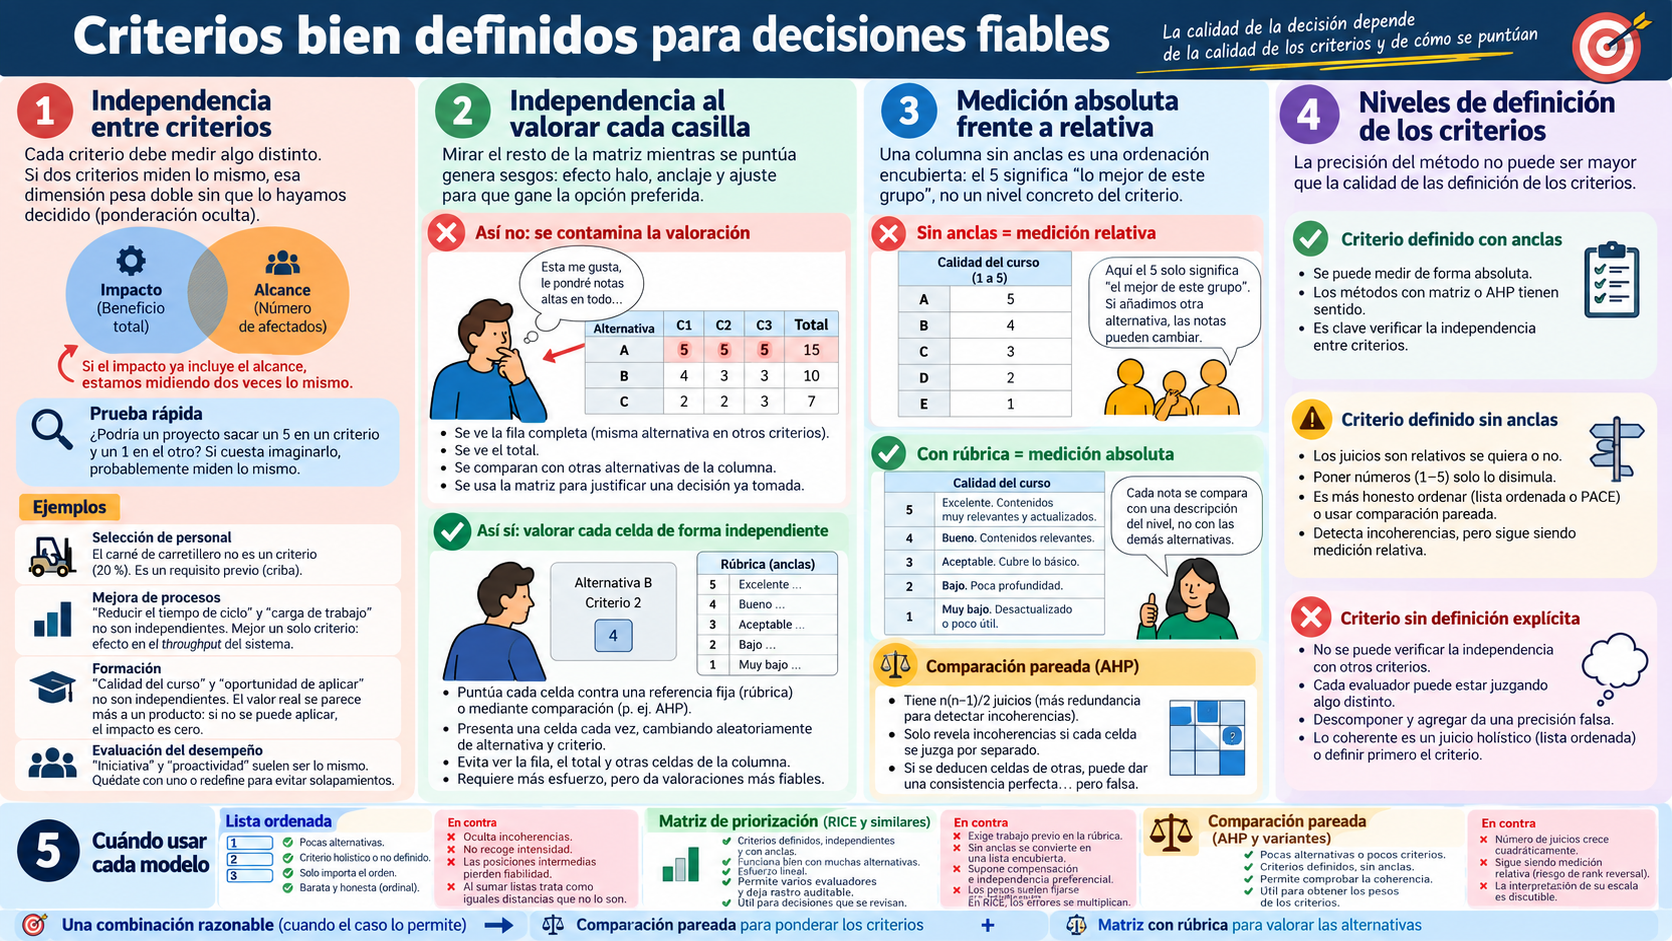
 

caracteristicas de los criterios de priorizacion que condicional técnicas a usar
© Juan A. Marín-García (2026) DOE-UPV-ROGLE-IEMAWith the support of the PIME/25-26/544 [Investigación acción para el diseño de los materiales, protocolo y análisis de viabilidad de una intervención compleja para analizar el impacto en la mejora del pensamiento crítico y el uso del marco de referencia del triple diamante en la toma de decisiones en grupo]. Universitat Politecnica de Valencia.

Universitat Politècnica de ValènciaROGLE, Reengineering Operations GroupWork Logistics Excellence

Visitas: 27

Del primer borrador a la causa raíz: qué suele fallar en un diagrama de 5 porqués

An English version is available here .

El primer error está antes de cualquier porqué. Si un efecto está mal definido, por ejemplo “Tenemos problemas de calidad”, no permite trabajar a nadie. El efecto tiene que poder medirse (qué defecto, en qué línea, cuánto, desde cuándo), porque todo el diagrama se va a contrastar contra él.

En la primera ronda casi siempre salen etiquetas vagas: “molde viejo”, “material malo”. Suenan a causa, pero no se pueden comprobar. La corrección consiste en bajar a la máquina o a los datos y reescribir el posit con algo verificable, lo que se ha visto o lo que dice la ficha técnica. Un posit que no se puede confirmar o descartar no sirve para seguir preguntando.

Con el culpable pasa algo parecido. “Operarios descuidados” o “el técnico no lo conectó” aparecen, y a veces muy abajo, cuando el grupo ya creía haber superado esa fase. Hay una prueba sencilla: si cambiando a la persona el problema seguiría ahí, la causa no es la persona. Se reescribe como conducta observable o como fallo del sistema (la tarea no tiene responsable, nadie enseña otra forma de reaccionar).

Algunas ideas son ciertas, pero responden a otra pregunta. “No se revisan las piezas” explica por qué el defecto llega al cliente, no por qué se produce. No se tira: se deja en espera de decisión, porque merece su propio análisis. Mezclarla con el resto contamina el diagrama. Los posits genéricos que solapan con otra rama (“falta mantenimiento”) se retiran sin más, y lo que tuvieran de cierto acaba saliendo más abajo con palabras concretas.

El error más frecuente, y el más difícil de ver, está en las flechas. Un posit puede estar bien escrito y colgar del sitio equivocado. Ocurre de dos maneras. La primera es poner como hermanas dos causas que en realidad son padre e hijo: subir la presión no está al lado de “presión alta”, la explica, y por eso tiene que bajar un nivel. La segunda es agrupar por tema en lugar de por causalidad. La secadora se pone bajo “material” porque todo lo del material parece ir junto, pero no explica que la fluidez varíe entre lotes. Explica el material húmedo, que está en otra rama y dos niveles más abajo. Cuando se descubre esto, el diagrama no se corrige añadiendo, se corrige moviendo cosas.

También faltan eslabones. Pasar de “el plan cuenta horas, no ciclos” a “desgaste en el molde” parece razonable hasta que se lee despacio: contar horas no desgasta nada. Falta el paso intermedio (el molde supera los ciclos previstos sin revisión), y al intercalarlo todo lo que cuelga debajo baja un nivel.

La herramienta para detectar tanto las flechas mal puestas como los huecos es leer cada rama en voz alta, de abajo arriba, uniendo los posits con “por tanto”. Si alguna frase chirría, ahí hay un problema.

Otro error es pararse demasiado pronto, en la causa técnica: la resistencia de la secadora está rota. Eso se arregla cambiando la resistencia, y la próxima avería volverá a pasar inadvertida. Se sigue preguntando hasta llegar a algo que depende de cómo está organizado el trabajo (las averías de equipos auxiliares no entran en el sistema de gestión de mantenimiento) y que admite una acción concreta con responsable. Ahí se para, y no antes. Por eso hacen falta cinco o seis niveles en las ramas largas, mientras que otras se cierran en tres. No hay que igualarlas.

Personalmente prefiero el formato en gota (“tear drop”) al diagrama de espina de pescado o de Ishikawa, y buena parte de los comentarios anteriores explican por qué. La espina de pescado arranca con categorías fijas (máquina, método, material, mano de obra, medio, medición) y eso empuja justo a agrupar por tema. La secadora acabaría en la espina de “máquina” o en la de “material”, y la relación con el material húmedo, que es lo que importa, quedaría escondida. La categoría “mano de obra” es además una invitación a apuntar culpables. En la gota no hay cajones previos: cada posit cuelga del posit al que explica, y la estructura sale de las relaciones causales, no de una clasificación.

La otra razón es la profundidad. Las espinas de pescado suelen quedarse anchas y planas, con muchas causas en el primer o segundo nivel y pocas cadenas que bajen de ahí, en parte porque en las espinas pequeñas no cabe casi nada. En la gota los niveles se ven: se nota de un vistazo qué rama se ha quedado corta, y el espacio crece hacia abajo justo donde aparecen más causas. Con posits, mover una idea de nivel o cambiarla de flecha es cuestión de segundos, y la lectura de abajo arriba con “por tanto” funciona porque cada cadena es una línea continua. No descarto las categorías del Ishikawa. Cuando un grupo se bloquea en la primera ronda, repasarlas ayuda a que salgan ideas. Las uso como lista de comprobación, no como estructura del diagrama.

Todo esto solo se ve si se acepta que el diagrama no se dibuja de una vez. Lo que sale en la primera media hora es un borrador, y la forma de gota aparece después de reescribir, mover y quitar posits varias veces.

Framework relacionado:

Marin-Garcia, J. A., Garcia-Sabater, J. J., Garcia-Sabater, J. P., & Maheut, J. (2020). Protocol: Triple Diamond method for problem solving and design thinking. Rubric validation. WPOM-Working Papers on Operations Management, 11(2), 49–68. https://doi.org/10.4995/wpom.v11i2.14776

Visitas: 25

From first draft to root cause: what usually goes wrong in a 5 Whys diagram

The first mistake comes before any why: a poorly defined effect. “We have quality problems”, for example, gives nobody anything to work with. The effect has to be measurable (which defect, on which line, how much, since when), because the whole diagram will be checked against it.

The first round almost always produces vague labels: “old mould”, “bad material”. They sound like causes, but they can’t be verified. The fix is to go down to the machine or to the data and rewrite the sticky note with something verifiable, whether it’s what was seen or what the process sheet says. A note that can’t be confirmed or ruled out is no use for asking the next why.

Something similar happens with blame. “Careless operators” or “the technician didn’t connect it” show up, sometimes far down the diagram, when the group thought it had moved past that stage. There is a simple test: if the problem would still be there with a different person, the cause isn’t the person. The note is rewritten as observable behaviour or as a failure of the system (the task has no owner, nobody teaches another way to react).

Some ideas are true but answer a different question. “Parts aren’t inspected” explains why the defect reaches the customer, not why it happens. It isn’t thrown away. It goes to “awaiting decision”, because it deserves its own analysis. Mixing it in with the rest contaminates the diagram. Generic notes that overlap with another branch (“lack of maintenance”) are simply removed, and whatever truth they held ends up surfacing further down in concrete terms.

The most frequent mistake, and the hardest to spot, is in the arrows. A note can be well written and hang from the wrong place. This happens in two ways. The first is placing two causes side by side as siblings when they are really parent and child: raising the pressure doesn’t sit next to “high pressure”, it explains it, so it has to drop a level. The second is grouping by topic instead of by causality. The dryer gets placed under “material” because everything about material seems to belong together, but it doesn’t explain why the flow index varies between batches. It explains the damp material, which is in another branch and two levels further down. When this comes to light, the diagram isn’t corrected by adding things. It’s corrected by moving them.

Links go missing too. Going from “the plan counts hours, not cycles” to “wear on the mould” seems reasonable until you read it slowly: counting hours doesn’t wear anything. The intermediate step is missing (the mould exceeds its planned cycles without inspection). Once it’s inserted, everything hanging below it drops a level.

The tool for catching both misplaced arrows and gaps is to read each branch aloud, bottom-up, joining the notes with “therefore”. If any sentence grates, there’s a problem there.

Another mistake is stopping too early, at the technical cause: the dryer’s heating element is broken. That gets fixed by replacing the element, and the next breakdown will go unnoticed again. You keep asking until you reach something that depends on how the work is organised (failures on auxiliary equipment aren’t logged in the maintenance management system) and that allows a concrete action with an owner. That’s where you stop, and not before. This is why the long branches need five or six levels while others close at three. There’s no need to even them out.

Personally, I prefer the tear drop format to the fishbone or Ishikawa diagram, and many of the mistakes above explain why. The fishbone starts from fixed categories (machine, method, material, manpower, environment, measurement), and that pushes people towards exactly the grouping by topic described above. The dryer would end up on the “machine” or the “material” bone, and its link to the damp material, which is what matters, would stay hidden. The “manpower” category is also an open invitation to write down culprits. In the tear drop there are no predefined boxes: each note hangs from the note it explains, and the structure comes from causal relationships, not from a classification.

The other reason is depth. Fishbone diagrams tend to end up wide and flat, with many causes on the first or second level and few chains going further. Part of the reason is that the small bones have almost no room. In the tear drop the levels are visible. You can see at a glance which branch has stopped short, and the space grows downwards precisely where more causes appear. With sticky notes, moving an idea to another level or another arrow takes seconds, and reading bottom-up with “therefore” works because each chain is a single continuous line. I don’t discard the Ishikawa categories. When a group gets stuck in the first round, going through them helps ideas come out. I use them as a checklist, not as the structure of the diagram.

None of this becomes visible unless you accept that the diagram isn’t drawn in one go. What comes out in the first half hour is a draft, and the tear drop shape emerges only after rewriting, moving and removing notes several times.


Related Framework:

Marin-Garcia, J. A., Garcia-Sabater, J. J., Garcia-Sabater, J. P., & Maheut, J. (2020). Protocol: Triple Diamond method for problem solving and design thinking. Rubric validation. WPOM-Working Papers on Operations Management, 11(2), 49–68. https://doi.org/10.4995/wpom.v11i2.14776

Visitas: 8

La autocensura del investigador: cómo el sistema de sexenios convierte a investigadores apasionados en burócratas estratégicos

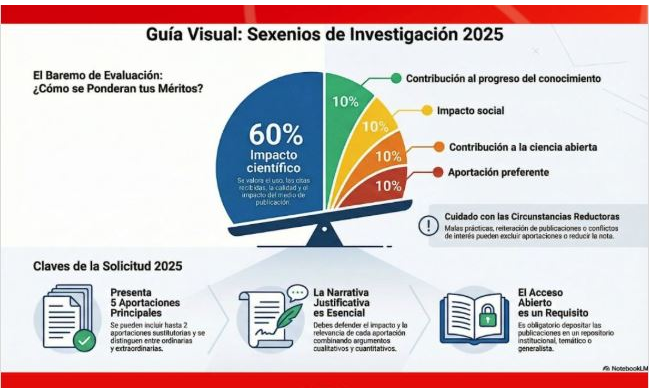
Ya he completado las tareas. Tanto la “obligatoria” de presentar los papeles en ANECA, como la voluntaria de hacer una reflexión personal (Rellenar sexenios de investigación: mi propuesta para transformarlo | Blog de Juan A. Marin-Garcia).

Voy a compartir mi reflexión personal del proceso, si me ha servido para algo y las sensaciones que me han ido provocando las diferentes decisiones que he ido tomando.

Empecemos por algunos hechos:

  • Tengo mucha producción. Me refiero a que tengo más de 7 posibles aportaciones (5 principales más dos sustitutorias). Eso es una ventaja porque me permite elegir. Es, al mismo tiempo, un fastidio porque me obliga a perder el tiempo tomando las decisiones sobre qué descartar. Decisiones que no son sencillas porque, al menos, hay 13 o 14 artículos con claro potencial. Luego hay varios artículos más que claramente no iban a ser candidatos -porque son protocolos y para mí confluyen con una de las aportaciones principales, o son de áreas ajenas al management o siempre fueron “artículos menores” que me interesaba escribir para dar cauce a una idea o para forzarme a aprender algo con rigor-.
  •  Algunas de las circunstancias reductoras de puntuación afectan directamente a varios de mis trabajos.

Y pasemos ahora a mis inferencias, opiniones y percepciones. Para mí, estos son los “takeaways” que me llevo del proceso de reflexión, siendo consciente de que son solo el modo en que veo el asunto y, sin duda, están sesgados.

Algunos de los que yo considero mis mejores trabajos por lo que ha supuesto escribirlos, la contribución que yo creo que tienen en la academia y en la sociedad y que, además, han sido de los más citados (no me creo que las citas indiquen nada, pero supongo que para mucha gente este es un indicador imprescindible), no los puedo poner como meritos porque sería un suicido (directamente me van a poner un cero porque cumplen alguno o varios de los criterios de minoración de puntuaciones). Por ejemplo:

  • Marin-Garcia, J. A., Vidal-Carreras, P. I., & Garcia-Sabater, J. J. (2021). The Role of Value Stream Mapping in Healthcare Services: A Scoping Review. International Journal of Environmental Research and Public Health, 18(3), 951. https://doi.org/10.3390/ijerph18030951

No me apetece jugármela a tener que defender mis méritos en una reclamación, de modo que voy a ser cauto y conservador y elegir como méritos los que creo que van a gustar al panel, no los que yo creo que realmente son mis mejores trabajos. Me he permitido la licencia de ser “irreductible” en una de las sustitutorias, donde he puesto una aportación de investigación sobre aprendizaje. Porque desde el primer sexenio me impuse el compromiso de poner siempre al menos una investigación docente en mis aportaciones:

  • Aznar-Mas, L. E., Atarés Huerta, L., & Marin-Garcia, J. A. (2021). Students have their say: Factors involved in students’ perception on their engineering degree. European Journal of Engineering Education, 46(6), 1007–1025. https://doi.org/10.1080/03043797.2021.1977244).

De las 5 aportaciones principales, yo solo habría mantenido una o dos de ellas (y también habría puesto otra en lugar de una de las sustitutorias). ¿Por qué no lo he hecho? Porque me “he cagado”. Tengo la seguridad de que no lo iban a entender en la comisión y que peligraba el sexenio… que no pasa nada, ya tengo 3 sexenios, y un sexenio son solo 140 euros al mes de extra en la nómina. Es triste, pero me he vendido por 140 euros de mierda (que, además, no me hacen falta para llegar a final de mes, esa enorme suerte tengo).

¿Cuales hubiera puesto yo de no haberme “cagado”? Sin duda, habría puesto al menos dos contribuciones sobre las cosas que hicimos durante la época de COVID, en la que nos volcamos  a dedicar horas y todos nuestros conocimientos para apoyar a los hospitales. A los que nos quisieron como colaboradores, y hasta que nos obligaron a dejar de colaborar con ellos desde las altas esferas (bueno, nunca les hicimos caso y seguimos desde la clandestinidad 😉 ). Gracias a ello, recibimos el premio “Luis Merelo y Más” del Colegio de Ingenieros Industriales de la Comunidad Valenciana. Muchas de las cosas que aprendimos entonces también las pudimos aplicar durante la catástrofe de la Dana del 2024. Como representativo de esta línea hubiera elegido estos dos trabajos:

  • Marin-Garcia, J. A., Garcia-Sabater, J. J. P., Ruiz, A., Maheut, J., & Garcia-Sabater, J. J. P. (2020). Operations Management at the service of health care management: Example of a proposal for action research to plan and schedule health resources in scenarios derived from the COVID-19 outbreak. Journal of Industrial Engineering and Management, 13(2), 213. https://doi.org/10.3926/jiem.3190
  • Redondo, E., Nicoletta, V., Bélanger, V., Garcia-Sabater, J. P., Landa, P., Maheut, J., Marin-Garcia, J. A., & Ruiz, A. (2023). A simulation model for predicting hospital occupancy for Covid-19 using archetype analysis. Healthcare Analytics, 3, 100197. https://doi.org/10.1016/j.health.2023.100197

Además, habría puesto mis artículos sobre guías para la difusión de la ciencia. Sinceramente creo que son de las cosas más útiles e interesantes que he hecho (aunque sea yo el único que piense eso):

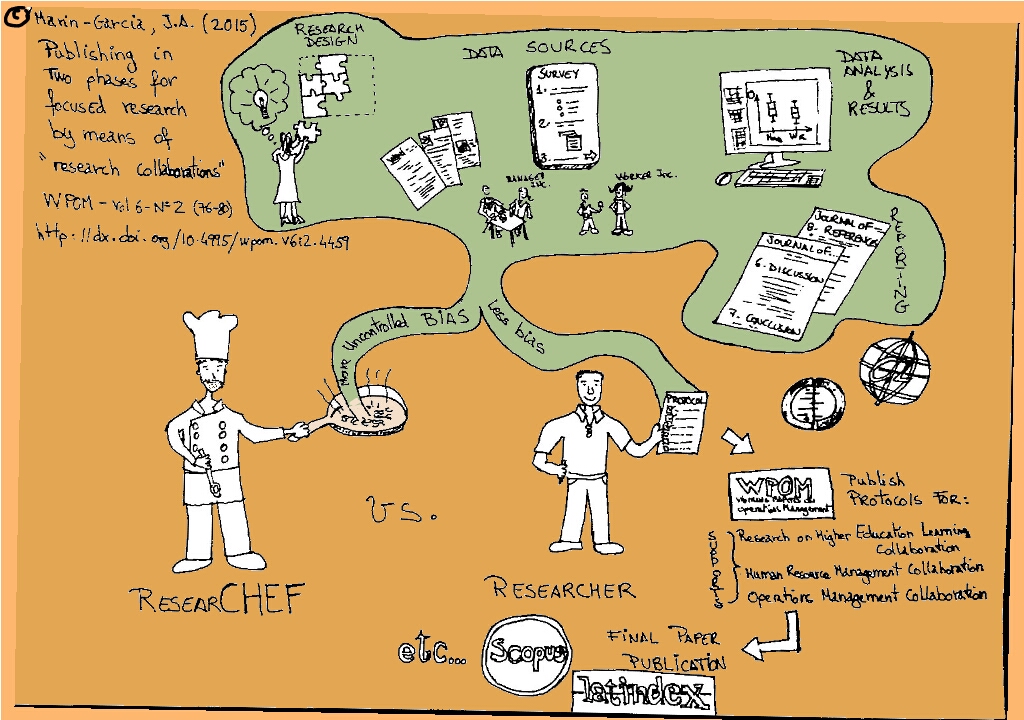
  • Marin-Garcia, J. A. (2021). Three-stage publishing to support evidence-based management practice. WPOM-Working Papers on Operations Management, 12(2), 56–95. https://doi.org/10.4995/wpom.11755
  • Marin-Garcia, J. A., & Alfalla-Luque, R. (2021). Teaching experiences based on action research: A guide to publishing in scientific journals. WPOM-Working Papers on Operations Management, 12(1), 42–50. https://doi.org/10.4995/wpom.7243
  • Marin-Garcia, J. A., Garcia-Sabater, J. P., & Maheut, J. (2022). Case report papers guidelines: Recommendations for the reporting of case studies or action research in Business Management. WPOM-Working Papers on Operations Management, 13(2), 108–137. https://doi.org/10.4995/wpom.16244
Sobre investigación docente habría elegido este, porque realmente es el trabajo que más transforma el aprendizaje de 60 futuros directivos-as cada año:
  • Marin-Garcia, J. A., Garcia-Sabater, J. J., Garcia-Sabater, J. P., & Maheut, J. (2020). Protocol: Triple Diamond method for problem solving and design thinking. Rubric validation. WPOM-Working Papers on Operations Management, 11(2), 49–68. https://doi.org/10.4995/wpom.v11i2.14776

También habría incluido alguna aportación representativa de mi línea de investigación en Gestión de Recursos Humanos. Mi solicitud ha quedado demasiado sesgada hacia la Dirección de Operaciones. Por ejemplo habría incluido:

  • Marin-Garcia, J. A., Bonavia, T., & Losilla, J. M. (2020). Changes in the Association between European Workers’ Employment Conditions and Employee Well-being in 2005, 2010 and 2015. Int J Environ Res Public Health, 17(3), 1048. https://doi.org/10.3390/ijerph17031048

Resumiendo, no me he atrevido a dejarme llevar por la interpretación que yo hago de cuál creo que es el espíritu de la norma. He preferido autocensurarme y hacer una solicitud estándar, del montón, doblegando mi espíritu crítico, mi creatividad, y mi compromiso con una pasión para encajar en el estrecho corsé de lo que creo (sin ninguna certeza) que se puntúa en mi campo científico. Esto me deja una profunda desazón y vergüenza. No ha sido una experiencia agradable el tener que pasar por esto. Y me deja preocupado. Si algo que no necesito es capaz de pervertir mi comportamiento, y hacer que me venda y me aleje de mis creencias solo por conseguir una métrica, estamos realmente “jodidos” en la academia.

Si no tuviera la seguridad de que me van a  sobrar aportaciones y que, por lo tanto, puedo dedicarme a investigar lo que creo, en conciencia, que es lo que debo investigar, habría tenido una enorme presión por dejar de hacer las cosas en las que creo, para dedicar mi escaso tiempo solo a las cosas que me van a puntuar. Por suerte, yo abordo todo lo que hago como un proyecto de publicación de artículos, lo que me genera un volumen alto de opciones y permite que, cosas que sé desde el principio que jamás serán puntuables, puedan tener su oportunidad de existir y ser encontradas por potenciales lectores.

Mientras escribo esta entrada, me ha llegado al mi bandeja de entrada este anuncio de publicación de artículo:

  • Baruch, Y., & Budhwar, P. (n.d.). Impact and management studies: Why making practical impact is not a core academic expectation. European Management Review. https://doi.org/10.1111/emre.70051
Ha sido providencial porque aborda muchas de las cosas que yo he estado pensando estas dos últimas semanas. Os dejo algunos apuntes a modo de trailer:
 
El artículo alerta sobre la creciente presión gubernamental para que la investigación demuestre un impacto práctico inmediato, lo que está erosionando la función fundamental de las universidades. Esta exigencia representa una ruptura con el modelo de universidad basado en la autonomía para la búsqueda libre del conocimiento.

El problema es tanto conceptual como metodológico. Por un lado, la naturaleza misma del trabajo académico en ciencias sociales genera impacto de forma indirecta y diferida: los académicos transforman la sociedad a través de sus estudiantes y del conocimiento que estos llevan al mundo profesional, un proceso cuyo valor se manifiesta a largo plazo. Por otro lado, la medición del impacto carece de criterios válidos y fiables, siendo prácticamente imposible establecer una relación causal directa entre una investigación específica y cambios sociales u organizacionales concretos.

Los autores no rechazan el valor del impacto práctico, sino su imposición como criterio central de evaluación académica. La creación de conocimiento, el rigor intelectual y la libertad académica deben constituir el “imperativo” de la universidad, mientras que la aplicación práctica inmediata puede ser un resultado deseable pero no una obligación. Invertir esta prioridad, convirtiendo el impacto como motor principal de la actividad académica, supone desviar recursos intelectuales de la generación de conocimiento original hacia la demostración de utilidad inmediata, comprometiendo así la esencia misma de la institución universitaria.

 
Universidad de Cádiz: Sexenios 2025 – Área de Biblioteca

Visitas: 156

What is learning in the age of generative AI? From panic to evidence

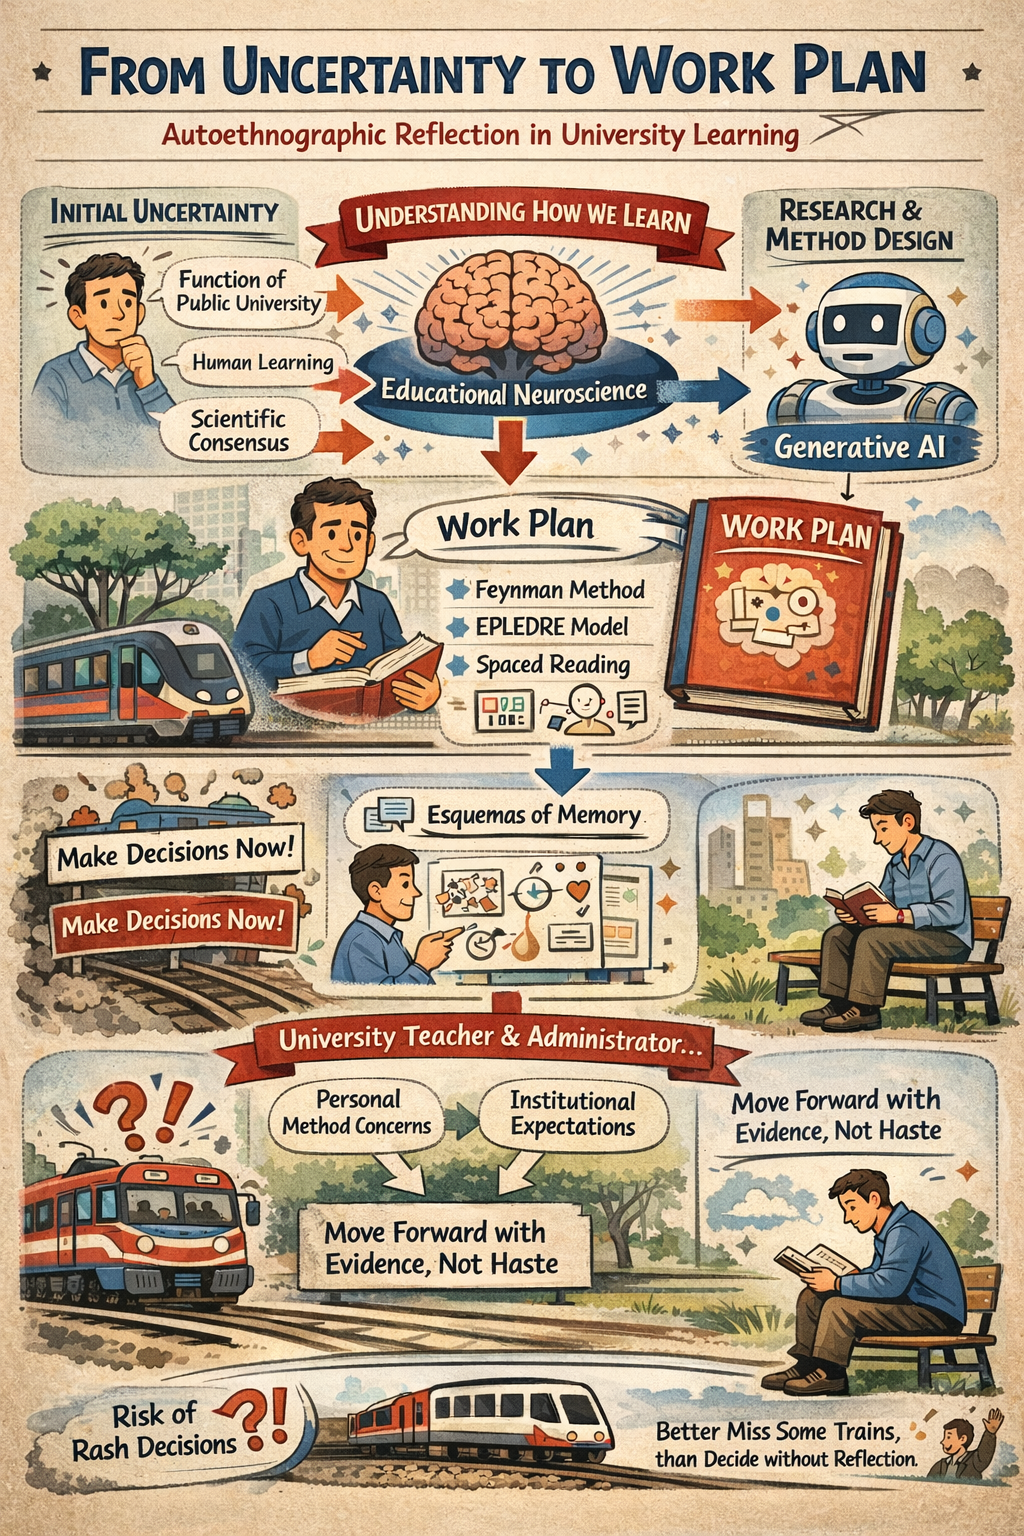
I will be presenting this research at the upcoming XVII International Workshop ACEDEDOT – OMTECH 2026, taking place in Almería, Spain, from March 12-14, 2026:

This communication presents an autoethnographic reflection. Building on four fundamental premises about the function of Spanish public universities and the established mechanisms of human learning, the author documents his personal journey from initial uncertainty to the design of a systematic work plan. The study focuses on understanding the current scientific consensus on how learning is consolidated in the brain and exploring the possibilities of generative AI to enhance this process in the university context. Drawing on the work of Héctor Ruiz Martín, a work plan is designed that combines recommendations from educational neuroscience with the Feynman method and the EPLEDRE model, including spaced reading, creation of sketchnote-type graphic schemes from memory, and public communication of the knowledge constructed. The communication shares the first graphic schemes developed and reflects on the author’s dual position as university teacher and administrator, facing both his own methodological uncertainties and institutional expectations for strategic guidance. It questions the “collective panic” surrounding the emergence of generative AI in universities and the pressure to make quick decisions without sufficient reflection. It proposes replacing reactive urgency with a deliberate process of calm, evidence-based reflection and pilot experimentation, recognizing that in contexts of accelerated change, it is preferable to miss some “trains” rather than make biased decisions under collective amygdala hijacking

Keywords: Learning; autoethnography; generative artificial intelligence; university learning; educational neuroscience; teaching transformation

Learning; autoethnography; generative artificial intelligence; university learning; educational neuroscience; teaching transformation

Visitas: 36

Optimizing the screening of scientific literature: Artificial or Human Intelligence?

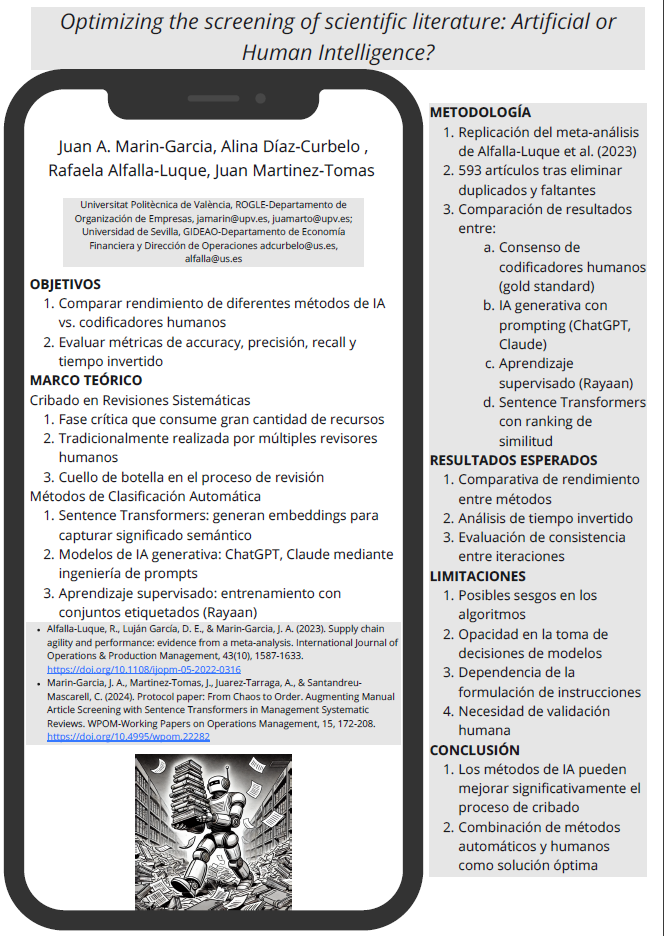
El 14 de marzo 2025, presentaremos nuestro trabajo Optimizing the screening of scientific literature: Artificial or Human Intelligence? en el XVI Workshop in Operations Management and Technology en Melilla.
This paper analyses the use of artificial intelligence (AI) in scientific literature screening, comparing its performance with the consensus of human researchers. The objective is to evaluate three methods: 1) generative AI using chatbots such as ChatGPT and Claude; 2) supervised learning with the Rayaan algorithm; and 3) similarity ranking based on sentence Transformers embeddings, proposed by Marin-Garcia et al. (2024). The study aims to determine whether any of these methods reduce manual effort and improve efficiency metrics such as accuracy, repeatability and time spent. It will also investigate the generalisability of these models to different scientific areas and whether the integration of multiple models improves the consistency of results in complex texts.

Alfalla- Luque, R., Luján García, D. E., & Marin- Garcia, J. A. (2023). Supply chain agility and performance: evidence from a meta- analysis. International Journal of Operations & Production Management, 43(10), 1587-1633. https://doi.org/10.1108/ijopm- 05- 2022- 0316
Marin- Garcia, J. A., Martinez- Tomas, J., Juarez- Tarraga, A., & Santandreu-Mascarell, C. (2024). Protocol paper: From Chaos to Order. Augmenting Manual Article Screening with Sentence Transformers in Management Systematic Reviews. WPOM- Working Papers on Operations Management, 15, 172-208. https://doi.org/10.4995/wpom.22282


Rafaela Alfalla-Luque Alina Díaz Curbelo Juan A. Marin-Garcia Juan Martínez cartoonabstract


Visitas: 51

Using AI to Make Literature Reviews Smarter and More Efficient

Marin-Garcia, J. A., Martinez-Tomas, J., Juarez-Tarraga, A., & Santandreu-Mascarell, C. (2024). Protocol paper: From Chaos to Order. Augmenting Manual Article Screening with Sentence Transformers in Management Systematic Reviews. WPOM-Working Papers on Operations Management, 15, 172–208. https://doi.org/10.4995/wpom.22282

What is it about?

This protocol paper describes a new method to help researchers screen and classify scientific articles more efficiently during systematic literature reviews. The authors propose using AI language models called “sentence transformers” to automatically analyze article titles and abstracts, comparing them to the review’s topic of interest. This helps researchers prioritize which articles to review first, rather than working through them randomly. The method was tested with 14 different AI models on a small set of articles about workplace management practices.

Featured Image

Why is it important?

As scientific publications grow exponentially, researchers struggle to efficiently review all relevant literature. This method could: * Save significant time in the screening process * Reduce researcher fatigue and potential bias * Make systematic reviews more accessible to researchers with limited resources * Help democratize access to advanced AI tools for academic research * Support evidence-based management practices by making literature reviews more feasible The approach is particularly valuable because it’s designed to complement rather than replace human judgment, and can be implemented using free, accessible tools.

Perspectives

This protocol represents an innovative bridge between cutting-edge AI technology and traditional academic research methods. The authors’ commitment to making the tool freely available and easy to use for researchers worldwide, regardless of technical expertise or resources, is particularly noteworthy. The pilot results suggest promising potential, though more testing is needed to validate the approach at larger scales.

Professor Juan A. Marin-Garcia
Universitat Politecnica de Valencia

Read the Original

This page is a summary of: Protocol paper: From Chaos to Order. Augmenting Manual Article Screening with Sentence Transformers in Management Systematic Reviews, WPOM – Working Papers on Operations Management, December 2024, Universitat Politecnica de Valencia,
DOI: 10.4995/wpom.22282.

Visitas: 17

A Three-Step Publishing Model to Support Evidence-Based Management

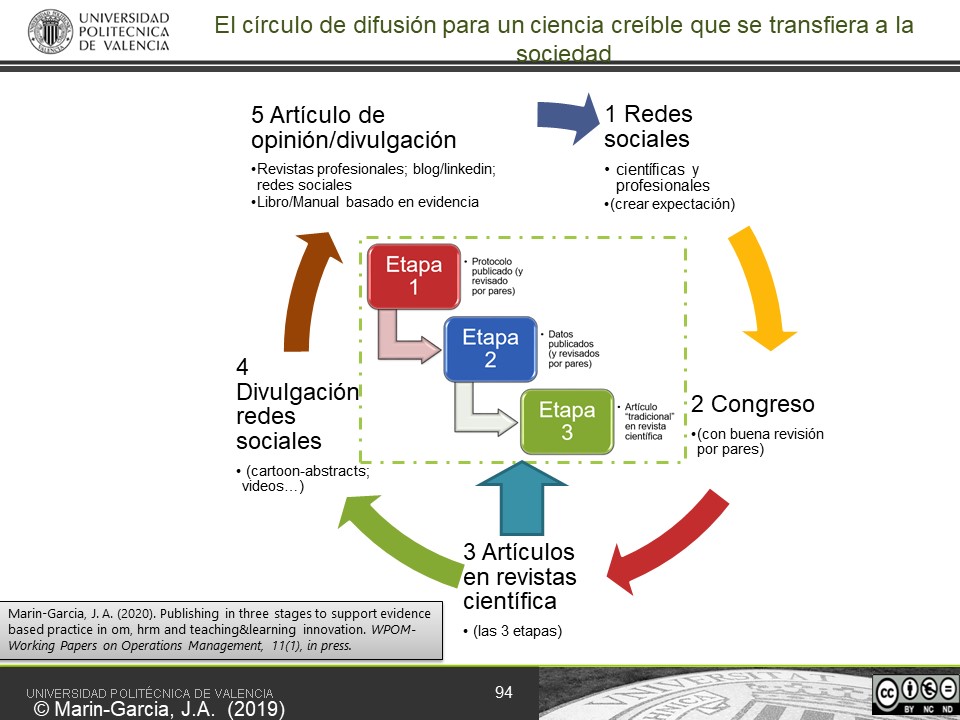
Marin-Garcia, J. A. (2021). Three-stage publishing to support evidence-based management practice. WPOM-Working Papers on Operations Management, 12(2), 56–95. https://doi.org/10.4995/wpom.11755 


What is it about?

This paper proposes a new model for publishing scientific research in business and management that aims to make studies more transparent and useful for practitioners. The model includes three key stages: 1) Publishing the research protocol/plan before starting, 2) Publishing the collected data, and 3) Publishing the final results and conclusions. This approach helps ensure research is well-planned, data is accessible for verification, and findings can be confidently applied in real-world management practice.

Featured Image

Why is it important?

Currently, there’s a big gap between management research and practice – many research findings never get implemented by actual managers. This model helps bridge that gap by: * Making the research process more transparent and trustworthy * Ensuring data quality through peer review at each stage * Making it easier for practitioners to access and understand findings * Encouraging more systematic, well-planned studies * Supporting evidence-based management decisions The model could significantly improve how management research is conducted and shared, ultimately making it more valuable for both academics and practitioners.

Perspectives

This innovative proposal challenges traditional publishing approaches in management research. While similar models exist in medicine and other fields, this is one of the first attempts to systematically apply such rigorous standards to business research. This offers a practical solution to improve research quality and impact. The detailed guidelines and examples make this a valuable roadmap for researchers wanting to conduct more transparent, reproducible studies.

Professor Juan A. Marin-Garcia
Universitat Politecnica de Valencia

Visitas: 18

Bienestar del trabajador ¿cuánto y cómo fomentarlo (o no disminuirlo)?

En este informe de Deloitte aparecen datos que quizás podrían parecer preocupantes (aun no tengo muy clara cuál es la diferencia de muestra y metodología entre el “self-reported” y “C-suite”)

mostrado en Malestar organizativo: 26% de directivos deprimidos y 40% sobrepasados | HABLEMOS DE TALENTO (juancarloscubeiro.com)

Casualmente tengo algunos archivos de datos que me permitirían comprobar si a mí me salen unas cifras parecidas. Es una de las cosas que me gustaría hacer al regreso de las vacaciones, si a mis estudiantes les interesa conocer el dato (o en redes sociales me contáis que podría ser algo interesante).

Supongo que sería interesante no solo conocer los niveles de bienestar, sino las palancas que ayudan a tenerlo o las barreras que lo reducen.

Hace un par de años publicamos Changes in the Association between European Workers’ Employment Conditions and Employee Well-Being in 2005, 2010 and 2015 (Marin-Garcia JA, Bonavia T, Losilla J-M. Changes in the Association between European Workers’ Employment Conditions and Employee Well-Being in 2005, 2010 and 2015. International Journal of Environmental Research and Public Health. 2020; 17(3):1048. https://doi.org/10.3390/ijerph17031048 ).

En ese trabajo analizábamos como afectaban determinadas condiciones de trabajo al “mental well-being” con los datos disponibles hasta el momento.

In general terms, and with the same situation for the adjustment variables (gender, age, level of education, seniority, occupation, establishment size, activity sector and economic activity), the people with indefinite contracts, no supervising responsibilities, who work between 36 and less than 45 h/week, do not work long working hours, do not have several jobs, do not work shifts (neither set nor alternating/rotating shifts) and do not work weekends report less anxiety, fatigue or job dissatisfaction than those in any of the other categories of each employment condition herein analyzed. That is, worse employment conditions lead to higher odds of suffering anxiety, fatigue or dissatisfaction compared to the reference category. Nonetheless, we observed that this relation did not always appear in this way for all the studied years for some working conditions (employment contracts other than indefinite contracts, supervising others and weekly working hours)

Para quien quiera “bucear” en los detalles, estas son las tablas de resultados. Son un poco complejas de entender para quien no esté acostumbrado a los “odds ratios”. Las cifras de la tabla comparan una opción de condición de trabajo (el encabezado de las columnas) con otra que se considera de referencia y nos indican la como aumenta (si el valor es mayor que 1) o disminuye (si es menor que 1) la probabilidad de sufrir uno de los síntomas (ansiedad, fatiga o insatisfacción).

Odds Ratio: the odds of having the target disorder in the observed group relative to the odds in favor of having the target disorder in the reference category group

Asi, por ejemplo, en la tabla 1, que compara tipos de contratos, las personas sin contrato, en el año 2015, tenían el doble de probabilidad de experimentar insatisfacción que las que tenían contrato indefinido. O, en la tabla 2, las personas que ocupaban puestos de supervisión, en el año 2015 tenían más probabilidad de sufrir ansiedad que las que personas que no supervisan el trabajo de otras (un valor 1,38 veces la probabilidad de las que no supervisaban). Curiosamente en el año 2005, la probabilidad para ese grupo era el 0,87 (es decir, menor) de la probabilidad de ansiedad en las que no supervisaban. Supervisar a otras personas generaba menos ansiedad en 2005 que en 2015, también generaba menos fatiga en 2005, mientras que en 2015 generaba más fatiga. Sin embargo supervisar a otras personas parece ser un factor protector contra la insatisfacción (están menos insatisfechos los que supervisan a otras personas) y se ha mantenido en los mismos niveles durante la serie de años estudiados.

Marin-Garcia JA, Bonavia T, Losilla J-M. Changes in the Association between European Workers’ Employment Conditions and Employee Well-Being in 2005, 2010 and 2015. International Journal of Environmental Research and Public Health. 2020; 17(3):1048. https://doi.org/10.3390/ijerph17031048

Visitas: 29

Visibilidad de buenas prácticas educativas: propuesta de investigación-acción en Universidad

Este será uno de los capítulos de mi proyecto de oposición


El objetivo de esta investigación acción es conocer cuáles son las expectativas de un conjunto de docentes respecto a la visibilidad de buenas prácticas educativas en el contexto de educación superior (universidad). Analizaremos la relación entre impacto y visibilidad de las buenas prácticas, exploraremos lo diferentes ámbitos donde se puede localizar el impacto, en qué ámbitos se plantean el impacto de sus buenas prácticas educativas y por qué, lo qué les preocupa, dónde encuentran las principales barreras o dudas, qué necesitan para poder tener una mejor visibilidad y si la rúbrica planteada en la editorial reciente (titulada: Experiencias docentes basadas en investigación-acción: guía para publicar en revistas científicas) es una herramienta útil para fomentar una mejor difusión de estas iniciativas.
Las personas participantes son una muestra de conveniencia de tamaño muy reducido, por lo que las conclusiones extraídas no pueden generalizarse y deberían estudiarse con muestras más amplias en investigación futura.
<a href=’https://www.freepik.es/vectores/escuela‘>Vector de Escuela creado por macrovector – www.freepik.es</a>
<a href=’https://www.freepik.es/vectores/fondo‘>Vector de Fondo creado por pikisuperstar – www.freepik.es</a>
<a href=’https://www.freepik.es/vectores/comida‘>Vector de Comida creado por upklyak – www.freepik.es</a>
<a href=’https://www.freepik.es/vectores/negocios‘>Vector de Negocios creado por pch.vector – www.freepik.es</a>
<a href=’https://www.freepik.es/vectores/escuela‘>Vector de Escuela creado por pch.vector – www.freepik.es</a>
<a href=’https://www.freepik.es/vectores/personas‘>Vector de Personas creado por freepik – www.freepik.es</a>
 

Visitas: 44