1) Trabajando en equipo en entornos presenciales, remotos e híbridos: Enlace a inscripción (disponible desde diciembre 2022-) 2) Liderazgo de equipos remotos: Enlace a inscripción (disponible desde noviembre 2022 -inicio curso marzo 2023-) 3) Habilidades de Comunicación interpersonal adaptada a equipos remotos: Enlace a inscripción (disponible desde noviembre 2022 -inicio curso mayo 2023-)
(versiones en inglés a partir de noviembre 2023)
Las competencias transversales (soft skills) son esenciales en prácticamente todos los puestos de trabajo actuales y complementan a las competencias técnicas (hard skills) para construir un perfil exitoso de las personas que abanderan/representan el talento de una organización. Para este programa hemos seleccionado un conjunto de tres competencias transversales cruciales (Trabajar en equipo, Influir positivamente en el comportamiento de las personas del equipo y comunicarse de manera efectiva con ellas). Este programa proporciona habilidades para trabajar en equipo en un entorno remoto, algo que ya es habitual en todas las instituciones y empresas y que cada vez lo será más.
Se sabe mucho sobre cómo usar estas competencias en entornos presenciales (y edX tiene ya moocs de esto). Sin embargo , existe un hueco en formación sobre cómo adaptar los comportamientos esenciales en cada competencia cuando el equipo trabaja remotamente.
In the post on what usually goes wrong in a 5 Whys diagram I explained why I prefer the tear drop format to the Ishikawa diagram, with an animation that rebuilt the process from a case of flash on an injection moulding line.
I have extended that analysis with three animations of the same case and an interactive guide that works as the entry point to everything else. The guide starts with three questions (where the group will work, how it usually gets started and what you need at the end) and gives back a recommendation. Below that there is a map with twelve criteria where each format is marked according to whether it helps, depends on the case or gets in the way, and clicking a row opens a longer comment.
The animations are the tear drop, the Ishikawa and the indented list. The tear drop one ends by showing the Mermaid code, which is a quick way of turning sticky notes into plain text without losing the relationships. For anyone who prefers to see it all at once there is also a summary table with the same criteria.
Even though I prefer the tear drop diagram, it has its own traps. Since there are no categories reminding you of other areas, it encourages tunnel vision (the first branches get explored in depth and the drop looks finished even if a whole branch is missing), and it shares blank page syndrome with the list. That is where the Ishikawa’s 6Ms do help, although I still use them as a checklist to get started or to review at the end, not as the structure of the diagram.
Another point worth noting is whether a single sticky note can have two arrows going to different branches. In the Ishikawa there is no option but to write the note twice, and in the list you have to repeat the line or leave a reference like “see line 8”, which then has to be kept up to date. In a tear drop diagram you just add another relationship.
The list has more going for it than it seems. For remote work with people who aren’t at ease on digital whiteboards (more common than we tend to assume) it is probably the safest option, and moving a whole branch is just cut, paste and Tab. What it loses is the overall view: with twenty lines you can no longer see which branch has stopped short.
References:
Marin-Garcia, J. A. (2026, [month day]). From first draft to root cause: What usually goes wrong in a 5 Whys diagram [Blog post]. Blog de Juan A. Marin-Garcia. https://jamg.blogs.upv.es/4585/
Marin-Garcia, J. A., Garcia-Sabater, J. J., Garcia-Sabater, J. P., & Maheut, J. (2020). Protocol: Triple Diamond method for problem solving and design thinking. Rubric validation. WPOM-Working Papers on Operations Management, 11(2), 49–68. https://doi.org/10.4995/wpom.v11i2.14776
En la entrada sobre qué suele fallar en un diagrama de 5 porqués explicaba por qué prefiero el formato en gota (“tear drop”) al Ishikawa, con una animación que reconstruía el proceso a partir de un caso de rebaba en una línea de inyección.
He ampliado ese análisis con tres animaciones del mismo caso y una guía interactiva que sirve como punto de entrada a todo lo demás. La guía empieza con tres preguntas (dónde va a trabajar el grupo, cómo suele arrancar y qué necesitas al terminar) y devuelve una recomendación. Debajo hay un mapa con doce criterios en el que cada formato aparece marcado según ayude, dependa del caso o estorbe, y al pulsar cada fila se abre un comentario más desarrollado.
Las animaciones son la de la gota, la del Ishikawa y la de la lista indentada. La de la gota termina enseñando el código Mermaid que es una forma rápida de convertir los posits en texto plano sin perder las relaciones. Para quien prefiera verlo todo de golpe hay también una tabla resumen con los mismos criterios.
A pesar de que prefiero el diagrama de gota, éste también tiene sus trampas. Como no hay categorías que recuerden otros frentes, favorece la visión de túnel (se profundiza en las primeras ramas y la gota parece terminada aunque falte una entera), y comparte con la lista el síndrome de la página en blanco. Ahí las 6M del Ishikawa sí ayudan, aunque yo las sigo usando como lista de comprobación para arrancar o para repasar al final, no como estructura del diagrama.
Otro aspecto a remarcar es si un mismo posit puede tener dos flechas hacia ramas distintas. En el Ishikawa no queda más remedio que escribir la nota dos veces, y en la lista hay que repetir la línea o dejar una referencia del tipo “ver línea 8” que luego hay que mantener al día. En un diagrama de gota añades una relación y ya está.
La lista tiene más a favor de lo que parece. Para trabajar en remoto con gente que no se maneja bien en pizarras digitales (que es más habitual de lo que solemos suponer) probablemente es la opción más segura, y mover una rama entera es cortar, pegar y tabular. Lo que pierde es la vista de conjunto: con veinte líneas ya no se ve qué rama se ha quedado corta.
Referencias:
Marin-Garcia, J. A. (2026, 29 de septiembre). Del primer borrador a la causa raíz: qué suele fallar en un diagrama de 5 porqués [Entrada de blog]. Blog de Juan A. Marin-Garcia. https://jamg.blogs.upv.es/4582/
Marin-Garcia, J. A., Garcia-Sabater, J. J., Garcia-Sabater, J. P., & Maheut, J. (2020). Protocol: Triple Diamond method for problem solving and design thinking. Rubric validation. WPOM-Working Papers on Operations Management, 11(2), 49–68. https://doi.org/10.4995/wpom.v11i2.14776
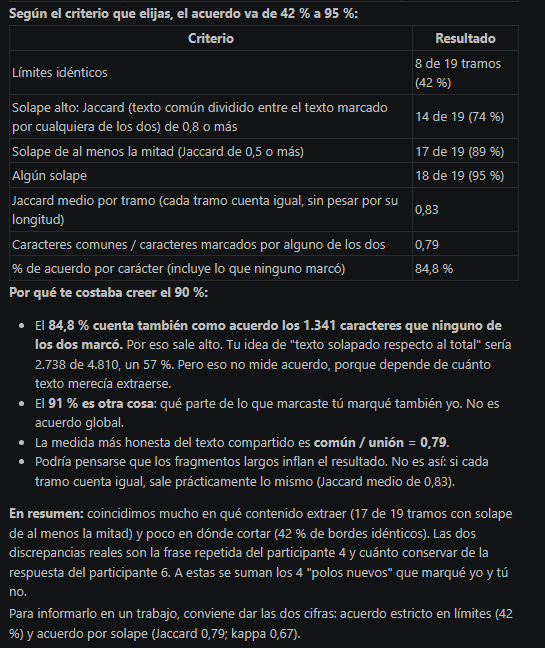
He etiquetado las respuestas a tres respuestas abiertas de 6 personas y luego le he pedido a Claude que, teniendo en cuenta cómo etiqueto yo, me genere un prompt de etiquetado. Luego le he pedido que etiquete los mismos textos siguiendo las instrucciones de su prompt y estos son los resultados.
Esta comparación es optimista porque las reglas se infirieron a partir de la extracción mía sobre estos mismos 6 participantes, y algunos ejemplos del prompt provienen de ellos. Una prueba de concordancia independiente requeriría que yo extrajera a ciegas una muestra de los participantes 7 a 40 (por ejemplo, 6 u 8) y la comparara con los fragmentos del código “claude”.
Durante estos últimos 11 meses he estado leyendo y reflexionando sobre qué es aprender (tanto en el contexto de la enseñanza universitaria como en el de aprendizaje organizacional) y si debía cambiar su definición ante el advenimiento omnipresente de la Inteligencia Artificial Generativa.
Esta es la definición que he creado y uso actualmente (y considero que sirve tanto para universidad como para empresa):
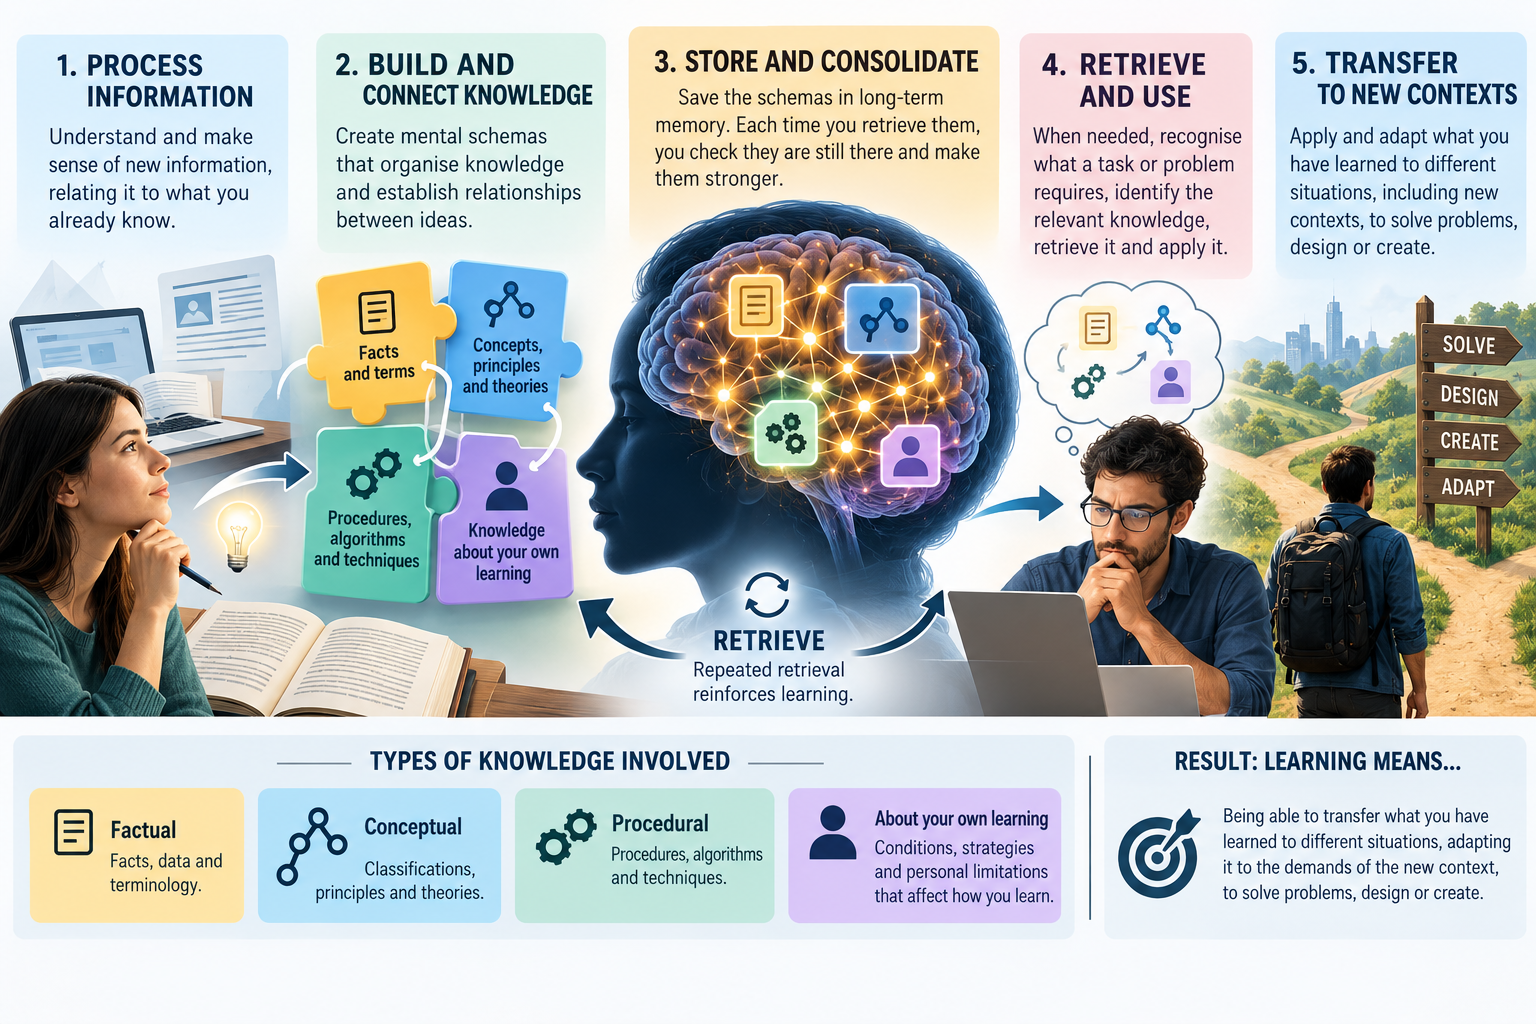
Aprender es construir, almacenar y consolidar en la memoria a largo plazo esquemas mentales que organizan los conocimientos y establecen relaciones entre ellos, de modo que puedan recuperarse y utilizarse cuando se necesiten. Estos conocimientos incluyen hechos y terminología; clasificaciones, principios y teorías; procedimientos, algoritmos y técnicas; y el conocimiento de las condiciones, estrategias y limitaciones personales que afectan a cómo se aprende. Su construcción y consolidación requieren procesar la información, relacionarla con los conocimientos previos y recuperar lo aprendido repetidas veces, lo cual contribuye a afianzarlo y a permitir su uso. En términos operativos, haber aprendido supone poder transferir lo aprendido a situaciones diferentes de aquellas en las que se adquirió y adaptarlo a las exigencias del nuevo contexto, para reconocer qué exige una tarea o un problema, identificar qué conocimientos se necesitan, recuperarlos y aplicarlos para resolverlo, crear o diseñar.
Dos aspectos que quiero remarcar de la definición:
Cada recuperación comprueba que el conocimiento sigue ahí y, además, refuerza el esquema.
El aprendizaje incluye el conjunto de relaciones entre los conocimientos, de modo que dos personas pueden conocer los mismos hechos y no haber aprendido lo mismo si los tienen conectados de manera diferente.
PD. Si quieres una definición más compacta, puedes usar esta (pero necesitas saber qué conocimientos son factuales, conceptuales, y procedimentales, que en la version larga están enumerados): Aprender es consolidar en la memoria a largo plazo, mediante procesamiento, anclaje en conocimientos previos y recuperación repetida, esquemas mentales que relacionan conocimientos (factuales, conceptuales, procedimentales y sobre el propio modo de aprender), de forma que puedan recuperarse cuando se necesiten para resolver problemas, diseñar o crear, incluso en contextos nuevos donde antes hay que reconocer qué conocimiento se requiere.
El martes pasado ocurrieron dos cosas sin relación aparente que me han hecho reflexionar sobre esto que os comparto.
Una amiga necesitaba “ver” cómo encajaban unas cosas en su terraza. Le pasé un plano (lo más natural del mundo, pensé: ahí está todo, a escala y con medidas). Su respuesta fue “no entiendo nada”. Mi primera reacción fue de extrañeza: “¿Cómo es posible que no entienda nada?”. Llevo dibujando e interpretando planos desde los 12 años, cuando ayudaba en la empresa de mi padre; luego vino la ingeniería y, a estas alturas, leer un plano me cuesta lo mismo que atarme los zapatos. Tan poco que ni se me pasó por la cabeza que le estaba hablando en un idioma que ella no hablaba.
La segunda fue en clase. Les di a mis estudiantes una plantilla en Excel y se quedaron alucinados de que la hubiera hecho yo. Vale, me costó unas tres o cuatro horas hacerla, había matrices y algunas fórmulas un poco incómodas de montar. Pero en mi cabeza no estaba archivado como un trabajo difícil. Era como escribir un correo largo: lleva su tiempo, y poco más.
Lo común de las dos historias es que yo no veía el esfuerzo de aprender un “lenguaje” o forma de representación nueva para ellas. Yo he ido adquiriendo esos lenguajes o frameworks a lo largo de la vida y dominarlos me ha supuesto esfuerzo para comprenderlos y repetir su uso hasta que se asentaran como un hábito.
Estas cosas ahora son obvias para mí desde hace décadas porque tengo un “expert blind spot” (Nathan y Petrosino, 2003). Cuanto más dominas una materia, peor predices lo que les costará a quienes empiezan. Supongo que este “blind spot” tiene algo que ver con los conceptos umbral de Meyer y Land (2003), esas ideas que, una vez cruzadas, cambian la forma en que ves toda una disciplina. Pero en lugar de ideas, son habilidades o modos de representación complejos que usas como lenguaje. Ambos son irreversibles. Cuando has aprendido a reconstruir un objeto en tres dimensiones a partir de una planta, un alzado y un perfil, ya no puedes dejar de verlo. Yo no recuerdo cómo era no saber leer un plano. No tengo acceso a esa versión de mí. El umbral se borra cuando lo cruzas, y con él la memoria de lo que costó cruzarlo.
Mis estudiantes no me dijeron “no entiendo nada” con la Excel; me dijeron que era impresionante. Y quizá ese asombro era la misma señal que me dio mi amiga, solo que en otra versión
Referencias:
Meyer, J. H. F., & Land, R. (2003). Threshold concepts and troublesome knowledge: Linkages to ways of thinking and practising within the disciplines (ETL Project Occasional Report 4). University of Edinburgh.
Nathan, M. J., & Petrosino, A. (2003). Expert blind spot among preservice teachers. American Educational Research Journal, 40(4), 905–928. https://doi.org/10.3102/00028312040004905
Coincide “plenamente” con lo que ahora pienso del tema, que es prácticamente lo mismo que pienso desde 2023. He leído, y probado muchas cosas desde entonces y apenas ha cambiado mi idea inicial. No sé si eso es una prueba de la consistencia de mis “argumentos” o un simple sesgo de confirmación. Yo sigo dándole vueltas al tema, si algún día cambio de opinión, os lo comparto.
“Students should only use AI for things they already know how to do well”
“In the workplace, the product is the thing. The report, the grant proposal, the manuscript, the R package, the Python notebook, the pitch deck, whatever. The product is the thing that matters, and here we all agree to this ideal that the human should be the lead in the driver’s seat, with AI being the associate.
In education, the product doesn’t matter. The product isn’t the point at all. Students produce products, but the product is seldom the point. No one wants to read the papers they write, and the math problems they solve have no practical value. Teachers have them do these tasks because they provide practice in cognitive abilities that we think matter.”
Quizás mi coincidencia no sea tan plena como lo que se dice literalmente. Es cierto que en el trabajo lo que importa es el producto, pero una organización que solo se centra en el producto no aprende. Lo que mejora el producto de mañana es entender cómo llegamos hasta ahí: qué decisiones tomamos, qué descartamos, dónde nos equivocamos y por qué. Eso es aprendizaje organizativo, lo que Argyris y Schön llamaban aprendizaje de doble bucle: no solo corregir el error, sino revisar los supuestos que lo produjeron. No hace falta hacerlo siempre, pero sí con cierta frecuencia, mediante retrospectivas y lecciones aprendidas. Si delegamos en la IA todo el proceso, incluso en tareas que dominamos, corremos el riesgo de que nadie en la organización conserve ese conocimiento tácito. Obtendremos el producto, pero habremos perdido la práctica que nos permitía mejorarlo y, sobre todo, juzgarlo. Por eso me resisto a aceptar que la frontera entre educación y trabajo sea tan nítida como sugiere el post original.
Resulta que mi postura apenas ha cambiado desde 2023, y ahora la estoy extendiendo al mundo laboral criticando el post original. Una opinión que se extende a otros campos suele estar más cerca del sesgo de confirmación que de la evidencia. Siguiendo la lógica de la gestión basada en evidencia (Pfeffer y Sutton, Center for Evidence-Based Management), consideraré estas frases como “proposiciones” o hipótesis, no como verdades confirmadas. Esto implica tres cosas:
Formularla de manera falsable. Por ejemplo: “los estudiantes que usan IA para tareas que aún no dominan retienen menos a largo plazo que quienes las practican sin ella”. Y para el trabajo: “los equipos que externalizan el proceso a la IA pierden capacidad de mejora continua”.
Definir de antemano qué evidencia me haría cambiar de opinión, antes de ver los datos.
Buscar activamente lo que me contradiga: estudios con resultados positivos para novatos usando IA intensivamente, contextos donde la práctica sin apoyo es ineficiente, y críticas a la visión cognitivista de lo que es el aprendizaje. También puedo contrastar mis ideas con alguien que piense lo contrario, o hacer un premortem (imaginar que dentro de un año estoy equivocado y preguntarme por qué).
Argyris. (2004). Reflection and Beyond in Research on Organizational Learning. Management Learning, 35, 507.
Argyris, C., & Schön, D. A. (1992). Theory in practice: Increasing professional effectiveness (1 ed. 1974, 6. print). Jossey-Bass Publ.
Pfeffer, J., & Sutton, R. I. (2006). Hard Facts, dangerous half-truths, and total nonsense. Profiting form evidence-based management. Harvard business review press.
Pfeffer, J., & Sutton, R. I. (2006). Evidence-based management. Harvard Business Review, 84(1), 62–74.
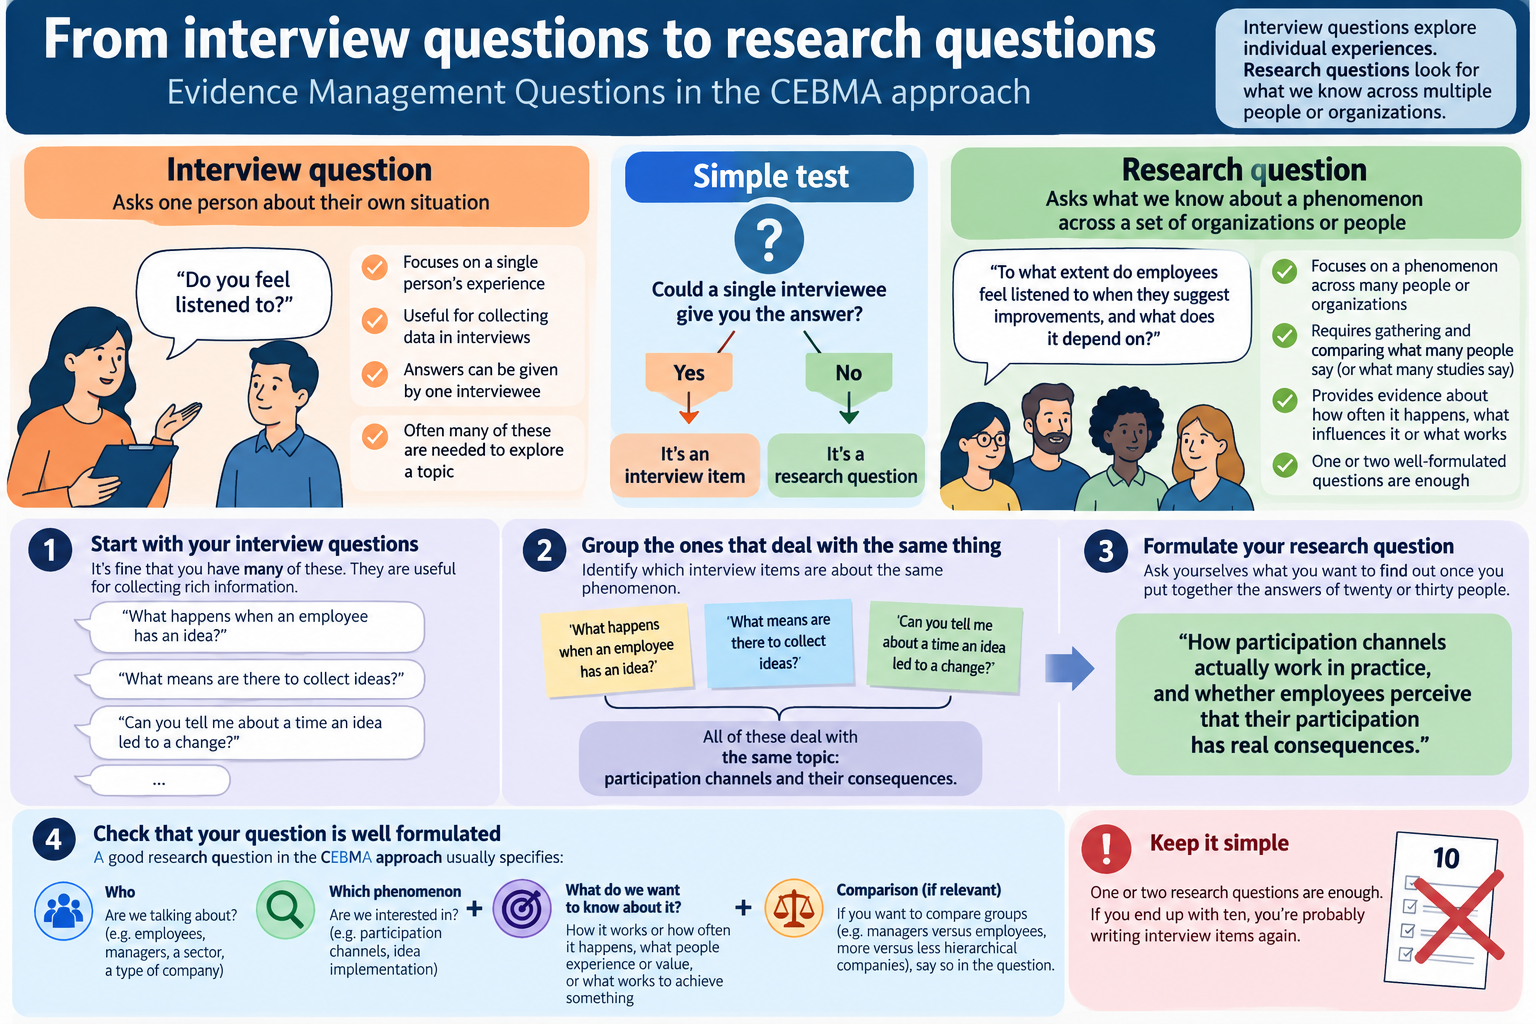
It is very easy to confuse good interview questions with good Evidence-Based Management questions. They are related, but they are not the same thing. An interview question is something you ask one person about their own experience:
Do you feel that your supervisor listens to your suggestions?
What usually happens when a machine breaks down during your shift?
Why do you think people leave this department?
Do you find the new scheduling system useful?
These can all be excellent questions. They may generate rich information, examples and stories. But they are still questions designed to collect data from individual respondents.
A management question operates at a different level. It asks what we want to understand once we combine evidence from several people, teams, sites, documents or studies.
For example:
To what extent do employees perceive that their improvement suggestions are taken into account, and what organizational factors influence that perception?
Or, in an operations context:
What factors are associated with recurring production disruptions, and how do operators and supervisors perceive the effectiveness of the current response process?
The difference may look subtle, but it matters.
A simple test: Could a single interviewee give me the answer? If the answer is yes, you probably have an interview question. If answering the question requires gathering evidence from several people, comparing experiences, identifying patterns, or combining interview evidence with other sources, then you are much closer to a management question. This distinction is particularly useful for junior professionals because, in practice, they are often given broad assignments such as:
Find out why productivity has fallen.
Understand why people are leaving.
See whether employees are really involved in continuous improvement.
Investigate why the new process is not working.
The temptation is to immediately prepare a long list of interview questions. But before doing that, it is worth deciding what you actually want to know.
Start from the interview questions, but do not stop there
You do not need to discard the questions you have already written. Instead, group the questions that appear to explore the same underlying phenomenon. Imagine, for example, that you are analysing employee participation in an operations team. You may have drafted questions such as:
What happens when an operator identifies an improvement opportunity?
How can employees submit improvement ideas?
Who decides whether an idea is implemented?
Can you remember an occasion when an employee’s suggestion resulted in a real change?
Do people receive feedback about the ideas they submit?
These are useful interview items. But together they point towards a broader question:
How do employee participation channels operate in practice, and to what extent do employees perceive that their suggestions lead to meaningful action?
That is the question that gives coherence to the interviews.
The same logic applies in people management. Suppose you are trying to understand voluntary turnover in a department. Your interview guide may contain questions about workload, supervision, promotion opportunities, scheduling, recognition, and team relationships. The management question might instead be:
What factors do employees and line managers associate with voluntary turnover in this department, and which of these factors appear consistently across different roles or teams?
Now the project has a clearer analytical purpose. You are not simply collecting twenty individual stories. You are looking for patterns, differences, and plausible explanations.
A good management question defines the scope of the problem
In the CEBMa approach, a useful Evidence-Based Management question normally makes several things reasonably explicit.
Absenteeism, employee voice, turnover, implementation of standard work, quality problems, safety behavior, workload, coordination between departments, and adoption of a new technology?
Third, what do we want to know about it?
How frequently does it occur?
How does the process operate?
How do people experience it?
What factors appear to influence it?
What consequences does it have?
What interventions seem to improve it?
And if a comparison is important, include that comparison explicitly.
For example:
How does perceived workload differ between production and support teams, and what organizational factors are associated with those differences?
Or:
How do highly standardized production units differ from less standardized units in the way operators report and resolve process deviations?
Once the comparison appears in the question, it becomes much harder to forget that you need to collect the corresponding information.
Why this matters in real organizational projects? The quality of the management question affects almost everything that follows. A vague question often produces a vague evidence-gathering exercise. You interview many people, collect dozens of interesting comments, and eventually discover that the material is difficult to synthesize because different interviews were actually exploring different issues. A clearer question helps you decide:
Whom you need to interview;
What information do you need to collect;
Which comparisons are relevant;
What additional organizational data may be useful;
What external research evidence you should look for.
Consider an operations problem such as recurring delays.
If the question is simply:
Why are there delays?
the investigation can quickly become unmanageable. But suppose you formulate it as:
What are the main sources of recurrent scheduling delays in the assembly process, and how consistently are these causes identified across operators, supervisors and production data?
That question immediately suggests several sources of evidence. You may need interviews with operators and supervisors, but you may also need downtime records, production schedules, quality data or process observations.
That is an important feature of Evidence-Based Management: interviews are one source of evidence, not necessarily the whole evidence base.
Do not confuse a long interview guide with a sophisticated research design. Junior professionals sometimes worry that having only one or two management questions makes a project look too simple. Usually the opposite is true. A well-defined management question can require many interview items, several evidence sources and substantial analysis. For example, one question about employee involvement in continuous improvement may require you to explore:
Access to participation channels
Managerial response
Psychological safety
Feedback mechanisms
Implementation rates
Perceived fairness
Differences between departments
Examples of successful and unsuccessful suggestions
Those are not eight separate management questions. They may simply be different aspects of one phenomenon that need to be examined carefully. This is why one or two strong questions are often enough. If you end up with ten “research questions,” there is a good chance that some of them are actually interview questions in disguise.
The practical shift
For someone starting a career in Operations Management or People Management, I think the most useful change in mindset is this:
Do not begin by asking, “What questions should I ask people?”
Begin by asking “What do we need to understand in order to make a better management decision?”
Then decide what evidence would help answer that question. Some of that evidence may come from interviews. Some may come from organizational data. Some may come from scientific research. Some may come from professional expertise or stakeholder concerns.
The interview guide comes later.
Moving from questions to ask individuals to questions the organization needs evidence to answer is one of the most important steps in turning an informal investigation into an Evidence-Based Management process.
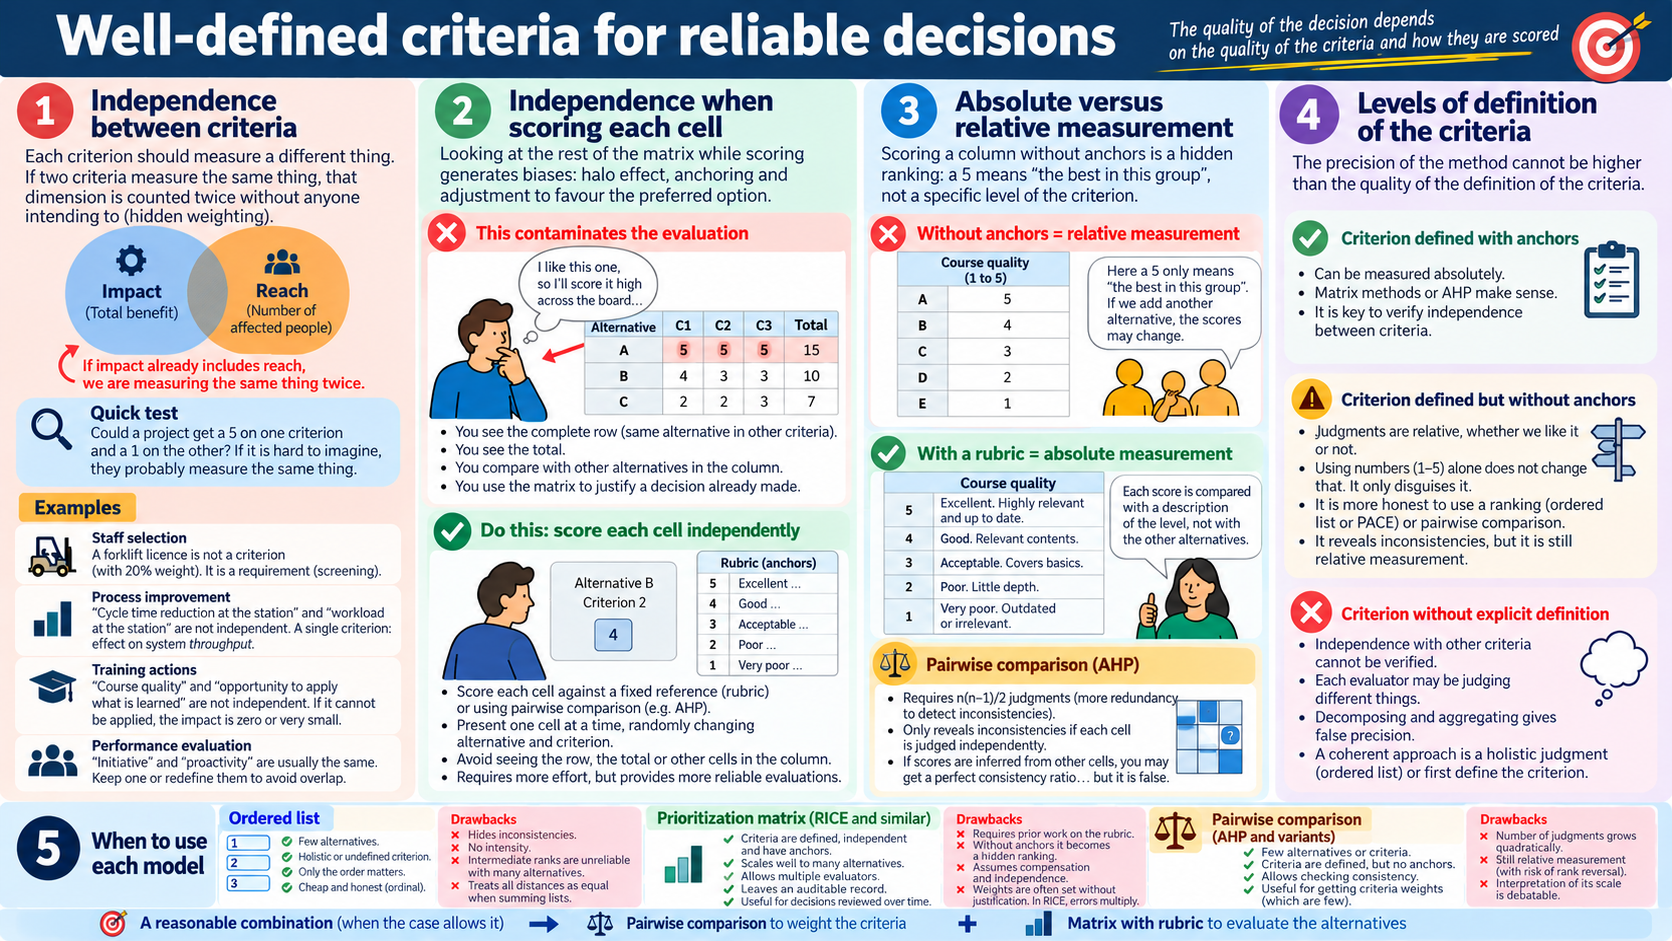
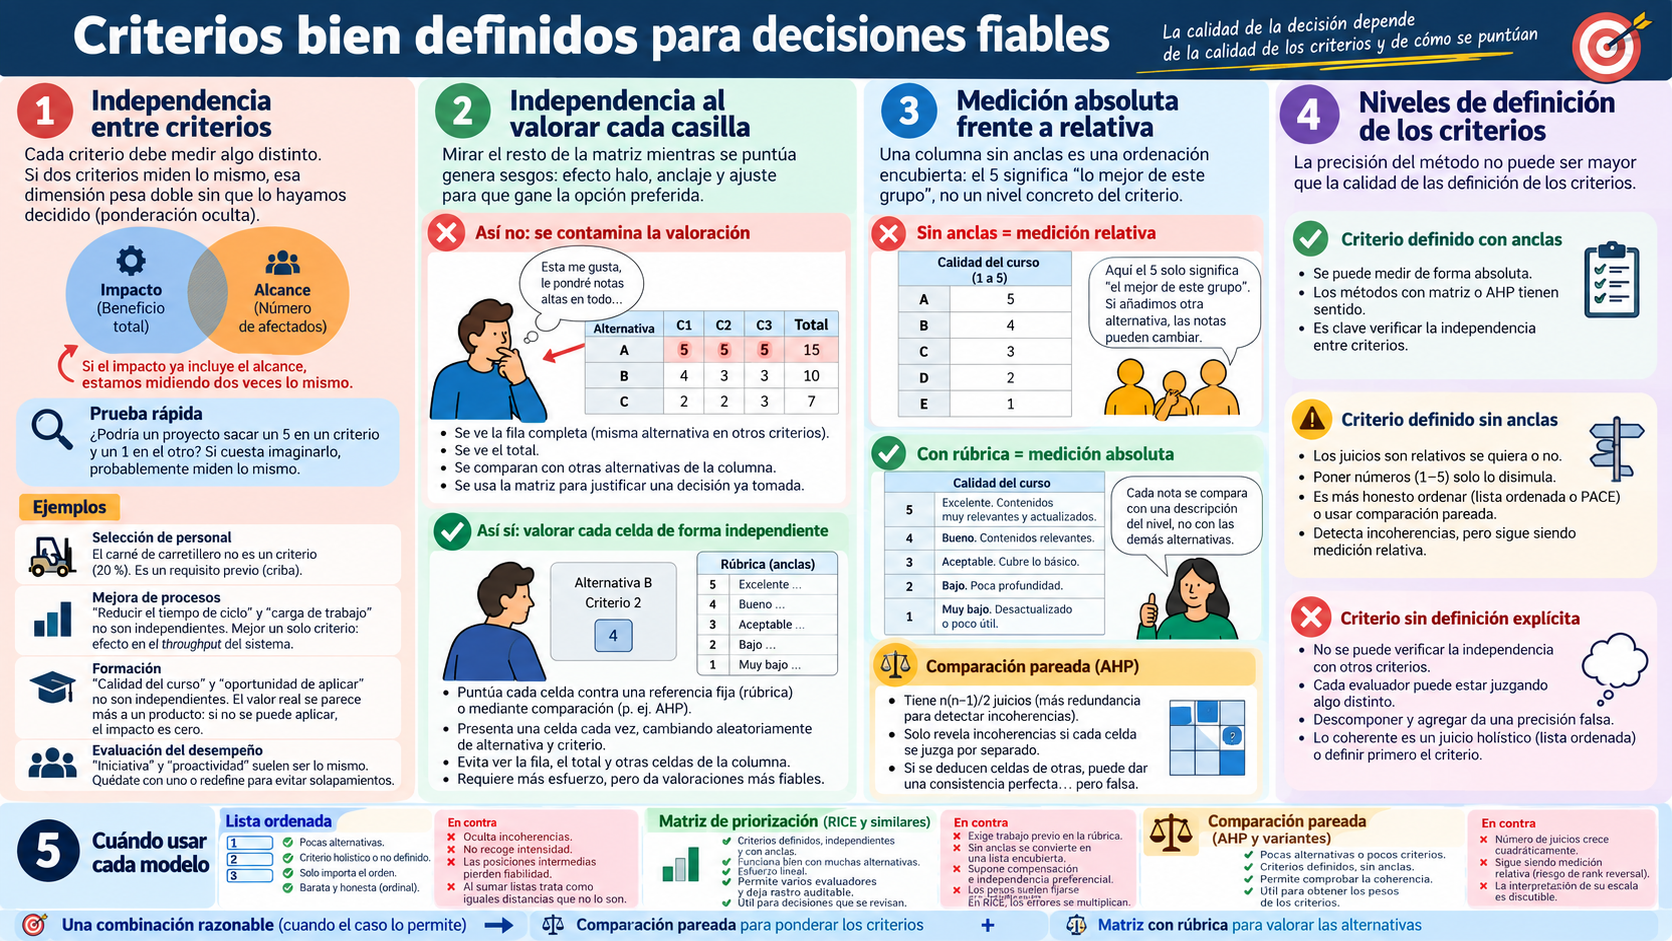
Más números, más criterios y más cálculos no implican necesariamente una decisión mejor. El rigor consiste en saber qué estamos midiendo, evitar contar dos veces lo mismo, mantener independientes los juicios y utilizar un método coherente con la calidad real de la información disponible.
Errores frecuentes que hacen que una matriz de priorización parezca más rigurosa de lo que realmente es:
Duplicar dimensiones sin darse cuenta. Si dos criterios miden aspectos iguales o muy solapados, esa dimensión entra varias veces en la decisión. Es una ponderación oculta.
Cuando el valor de un criterio depende del nivel de otro, asignarles pesos separados puede no tener sentido.
Confundir criterios con requisitos. Hay condiciones que no deberían recibir un peso ni compensarse con otras. Si algo es imprescindible (por ejemplo, disponer de una habilitación necesaria para un puesto) debe funcionar como filtro o umbral previo, no como una columna más de la matriz.
Puntuar viendo la alternativa completa. Cuando el evaluador ve simultáneamente la fila, las demás puntuaciones y, sobre todo, el total, aparecen el efecto halo, el anclaje y los ajustes para que gane la alternativa preferida. La matriz deja entonces de ayudar a tomar la decisión y pasa a justificar una decisión que, consciente o inconscientemente, ya estaba tomada. La unidad de juicio debería ser cada celda, valorada de la forma más independiente posible.
Creer que poner números convierte un juicio relativo en una medición absoluta. Una escala 1–5 sin anclas descriptivas no significa necesariamente que “4” represente un nivel objetivo. Con frecuencia significa simplemente “mejor que estas alternativas y peor que aquellas”. Es decir, es una ordenación relativa disfrazada de medición. La medición absoluta requiere una rúbrica que describa qué significa cada nivel.
Usar métodos sofisticados con criterios mal definidos. Si “encaje estratégico”, “impacto” o “calidad” significan cosas diferentes para cada evaluador, hacer más cálculos no aumenta la calidad de la decisión. Puede producir justo lo contrario. Genera una falsa rigurosidad, fundamentada en la precisión matemática, que se basa en juicios imprecisos. La sofisticación del método no debería superar la calidad de la definición de los criterios.
Desaprovechar la redundancia de la comparación pareada. AHP y otros métodos de comparación pareada de alternativas exigen muchos más juicios precisamente porque esa redundancia permite detectar inconsistencias. Si unas comparaciones se deducen de otras para ahorrar trabajo, puede obtenerse una consistencia aparentemente perfecta, pero se ha eliminado precisamente la información que justificaba realizar las comparaciones adicionales.
Elegir el método por su apariencia de rigor y no por el problema de medición. Una lista ordenada puede ser la opción más adecuada cuando el juicio es holístico o los criterios están poco definidos. Una matriz de priorización tiene sentido cuando los criterios están bien definidos, son lo bastante independientes y existen anclas que permitan valorar las alternativas. La comparación pareada resulta especialmente útil cuando los criterios están definidos, pero no existen buenas anclas, y queremos hacer explícitos los juicios relativos y comprobar su coherencia.
El primer error está antes de cualquier porqué. Si un efecto está mal definido, por ejemplo “Tenemos problemas de calidad”, no permite trabajar a nadie. El efecto tiene que poder medirse (qué defecto, en qué línea, cuánto, desde cuándo), porque todo el diagrama se va a contrastar contra él.
En la primera ronda casi siempre salen etiquetas vagas: “molde viejo”, “material malo”. Suenan a causa, pero no se pueden comprobar. La corrección consiste en bajar a la máquina o a los datos y reescribir el posit con algo verificable, lo que se ha visto o lo que dice la ficha técnica. Un posit que no se puede confirmar o descartar no sirve para seguir preguntando.
Con el culpable pasa algo parecido. “Operarios descuidados” o “el técnico no lo conectó” aparecen, y a veces muy abajo, cuando el grupo ya creía haber superado esa fase. Hay una prueba sencilla: si cambiando a la persona el problema seguiría ahí, la causa no es la persona. Se reescribe como conducta observable o como fallo del sistema (la tarea no tiene responsable, nadie enseña otra forma de reaccionar).
Algunas ideas son ciertas, pero responden a otra pregunta. “No se revisan las piezas” explica por qué el defecto llega al cliente, no por qué se produce. No se tira: se deja en espera de decisión, porque merece su propio análisis. Mezclarla con el resto contamina el diagrama. Los posits genéricos que solapan con otra rama (“falta mantenimiento”) se retiran sin más, y lo que tuvieran de cierto acaba saliendo más abajo con palabras concretas.
El error más frecuente, y el más difícil de ver, está en las flechas. Un posit puede estar bien escrito y colgar del sitio equivocado. Ocurre de dos maneras. La primera es poner como hermanas dos causas que en realidad son padre e hijo: subir la presión no está al lado de “presión alta”, la explica, y por eso tiene que bajar un nivel. La segunda es agrupar por tema en lugar de por causalidad. La secadora se pone bajo “material” porque todo lo del material parece ir junto, pero no explica que la fluidez varíe entre lotes. Explica el material húmedo, que está en otra rama y dos niveles más abajo. Cuando se descubre esto, el diagrama no se corrige añadiendo, se corrige moviendo cosas.
También faltan eslabones. Pasar de “el plan cuenta horas, no ciclos” a “desgaste en el molde” parece razonable hasta que se lee despacio: contar horas no desgasta nada. Falta el paso intermedio (el molde supera los ciclos previstos sin revisión), y al intercalarlo todo lo que cuelga debajo baja un nivel.
La herramienta para detectar tanto las flechas mal puestas como los huecos es leer cada rama en voz alta, de abajo arriba, uniendo los posits con “por tanto”. Si alguna frase chirría, ahí hay un problema.
Otro error es pararse demasiado pronto, en la causa técnica: la resistencia de la secadora está rota. Eso se arregla cambiando la resistencia, y la próxima avería volverá a pasar inadvertida. Se sigue preguntando hasta llegar a algo que depende de cómo está organizado el trabajo (las averías de equipos auxiliares no entran en el sistema de gestión de mantenimiento) y que admite una acción concreta con responsable. Ahí se para, y no antes. Por eso hacen falta cinco o seis niveles en las ramas largas, mientras que otras se cierran en tres. No hay que igualarlas.
Personalmente prefiero el formato en gota (“tear drop”) al diagrama de espina de pescado o de Ishikawa, y buena parte de los comentarios anteriores explican por qué. La espina de pescado arranca con categorías fijas (máquina, método, material, mano de obra, medio, medición) y eso empuja justo a agrupar por tema. La secadora acabaría en la espina de “máquina” o en la de “material”, y la relación con el material húmedo, que es lo que importa, quedaría escondida. La categoría “mano de obra” es además una invitación a apuntar culpables. En la gota no hay cajones previos: cada posit cuelga del posit al que explica, y la estructura sale de las relaciones causales, no de una clasificación.
La otra razón es la profundidad. Las espinas de pescado suelen quedarse anchas y planas, con muchas causas en el primer o segundo nivel y pocas cadenas que bajen de ahí, en parte porque en las espinas pequeñas no cabe casi nada. En la gota los niveles se ven: se nota de un vistazo qué rama se ha quedado corta, y el espacio crece hacia abajo justo donde aparecen más causas. Con posits, mover una idea de nivel o cambiarla de flecha es cuestión de segundos, y la lectura de abajo arriba con “por tanto” funciona porque cada cadena es una línea continua. No descarto las categorías del Ishikawa. Cuando un grupo se bloquea en la primera ronda, repasarlas ayuda a que salgan ideas. Las uso como lista de comprobación, no como estructura del diagrama.
Todo esto solo se ve si se acepta que el diagrama no se dibuja de una vez. Lo que sale en la primera media hora es un borrador, y la forma de gota aparece después de reescribir, mover y quitar posits varias veces.
Framework relacionado:
Marin-Garcia, J. A., Garcia-Sabater, J. J., Garcia-Sabater, J. P., & Maheut, J. (2020). Protocol: Triple Diamond method for problem solving and design thinking. Rubric validation. WPOM-Working Papers on Operations Management, 11(2), 49–68. https://doi.org/10.4995/wpom.v11i2.14776
The first mistake comes before any why: a poorly defined effect. “We have quality problems”, for example, gives nobody anything to work with. The effect has to be measurable (which defect, on which line, how much, since when), because the whole diagram will be checked against it.
The first round almost always produces vague labels: “old mould”, “bad material”. They sound like causes, but they can’t be verified. The fix is to go down to the machine or to the data and rewrite the sticky note with something verifiable, whether it’s what was seen or what the process sheet says. A note that can’t be confirmed or ruled out is no use for asking the next why.
Something similar happens with blame. “Careless operators” or “the technician didn’t connect it” show up, sometimes far down the diagram, when the group thought it had moved past that stage. There is a simple test: if the problem would still be there with a different person, the cause isn’t the person. The note is rewritten as observable behaviour or as a failure of the system (the task has no owner, nobody teaches another way to react).
Some ideas are true but answer a different question. “Parts aren’t inspected” explains why the defect reaches the customer, not why it happens. It isn’t thrown away. It goes to “awaiting decision”, because it deserves its own analysis. Mixing it in with the rest contaminates the diagram. Generic notes that overlap with another branch (“lack of maintenance”) are simply removed, and whatever truth they held ends up surfacing further down in concrete terms.
The most frequent mistake, and the hardest to spot, is in the arrows. A note can be well written and hang from the wrong place. This happens in two ways. The first is placing two causes side by side as siblings when they are really parent and child: raising the pressure doesn’t sit next to “high pressure”, it explains it, so it has to drop a level. The second is grouping by topic instead of by causality. The dryer gets placed under “material” because everything about material seems to belong together, but it doesn’t explain why the flow index varies between batches. It explains the damp material, which is in another branch and two levels further down. When this comes to light, the diagram isn’t corrected by adding things. It’s corrected by moving them.
Links go missing too. Going from “the plan counts hours, not cycles” to “wear on the mould” seems reasonable until you read it slowly: counting hours doesn’t wear anything. The intermediate step is missing (the mould exceeds its planned cycles without inspection). Once it’s inserted, everything hanging below it drops a level.
The tool for catching both misplaced arrows and gaps is to read each branch aloud, bottom-up, joining the notes with “therefore”. If any sentence grates, there’s a problem there.
Another mistake is stopping too early, at the technical cause: the dryer’s heating element is broken. That gets fixed by replacing the element, and the next breakdown will go unnoticed again. You keep asking until you reach something that depends on how the work is organised (failures on auxiliary equipment aren’t logged in the maintenance management system) and that allows a concrete action with an owner. That’s where you stop, and not before. This is why the long branches need five or six levels while others close at three. There’s no need to even them out.
Personally, I prefer the tear drop format to the fishbone or Ishikawa diagram, and many of the mistakes above explain why. The fishbone starts from fixed categories (machine, method, material, manpower, environment, measurement), and that pushes people towards exactly the grouping by topic described above. The dryer would end up on the “machine” or the “material” bone, and its link to the damp material, which is what matters, would stay hidden. The “manpower” category is also an open invitation to write down culprits. In the tear drop there are no predefined boxes: each note hangs from the note it explains, and the structure comes from causal relationships, not from a classification.
The other reason is depth. Fishbone diagrams tend to end up wide and flat, with many causes on the first or second level and few chains going further. Part of the reason is that the small bones have almost no room. In the tear drop the levels are visible. You can see at a glance which branch has stopped short, and the space grows downwards precisely where more causes appear. With sticky notes, moving an idea to another level or another arrow takes seconds, and reading bottom-up with “therefore” works because each chain is a single continuous line. I don’t discard the Ishikawa categories. When a group gets stuck in the first round, going through them helps ideas come out. I use them as a checklist, not as the structure of the diagram.
None of this becomes visible unless you accept that the diagram isn’t drawn in one go. What comes out in the first half hour is a draft, and the tear drop shape emerges only after rewriting, moving and removing notes several times.
Related Framework:
Marin-Garcia, J. A., Garcia-Sabater, J. J., Garcia-Sabater, J. P., & Maheut, J. (2020). Protocol: Triple Diamond method for problem solving and design thinking. Rubric validation. WPOM-Working Papers on Operations Management, 11(2), 49–68. https://doi.org/10.4995/wpom.v11i2.14776