Coincide “plenamente” con lo que ahora pienso del tema, que es prácticamente lo mismo que pienso desde 2023. He leído, y probado muchas cosas desde entonces y apenas ha cambiado mi idea inicial. No sé si eso es una prueba de la consistencia de mis “argumentos” o un simple sesgo de confirmación. Yo sigo dándole vueltas al tema, si algún día cambio de opinión, os lo comparto.
“Students should only use AI for things they already know how to do well”
“In the workplace, the product is the thing. The report, the grant proposal, the manuscript, the R package, the Python notebook, the pitch deck, whatever. The product is the thing that matters, and here we all agree to this ideal that the human should be the lead in the driver’s seat, with AI being the associate.
In education, the product doesn’t matter. The product isn’t the point at all. Students produce products, but the product is seldom the point. No one wants to read the papers they write, and the math problems they solve have no practical value. Teachers have them do these tasks because they provide practice in cognitive abilities that we think matter.”
Quizás mi coincidencia no sea tan plena como lo que se dice literalmente. Es cierto que en el trabajo lo que importa es el producto, pero una organización que solo se centra en el producto no aprende. Lo que mejora el producto de mañana es entender cómo llegamos hasta ahí: qué decisiones tomamos, qué descartamos, dónde nos equivocamos y por qué. Eso es aprendizaje organizativo, lo que Argyris y Schön llamaban aprendizaje de doble bucle: no solo corregir el error, sino revisar los supuestos que lo produjeron. No hace falta hacerlo siempre, pero sí con cierta frecuencia, mediante retrospectivas y lecciones aprendidas. Si delegamos en la IA todo el proceso, incluso en tareas que dominamos, corremos el riesgo de que nadie en la organización conserve ese conocimiento tácito. Obtendremos el producto, pero habremos perdido la práctica que nos permitía mejorarlo y, sobre todo, juzgarlo. Por eso me resisto a aceptar que la frontera entre educación y trabajo sea tan nítida como sugiere el post original.
Resulta que mi postura apenas ha cambiado desde 2023, y ahora la estoy extendiendo al mundo laboral criticando el post original. Una opinión que se extende a otros campos suele estar más cerca del sesgo de confirmación que de la evidencia. Siguiendo la lógica de la gestión basada en evidencia (Pfeffer y Sutton, Center for Evidence-Based Management), consideraré estas frases como “proposiciones” o hipótesis, no como verdades confirmadas. Esto implica tres cosas:
Formularla de manera falsable. Por ejemplo: “los estudiantes que usan IA para tareas que aún no dominan retienen menos a largo plazo que quienes las practican sin ella”. Y para el trabajo: “los equipos que externalizan el proceso a la IA pierden capacidad de mejora continua”.
Definir de antemano qué evidencia me haría cambiar de opinión, antes de ver los datos.
Buscar activamente lo que me contradiga: estudios con resultados positivos para novatos usando IA intensivamente, contextos donde la práctica sin apoyo es ineficiente, y críticas a la visión cognitivista de lo que es el aprendizaje. También puedo contrastar mis ideas con alguien que piense lo contrario, o hacer un premortem (imaginar que dentro de un año estoy equivocado y preguntarme por qué).
Argyris. (2004). Reflection and Beyond in Research on Organizational Learning. Management Learning, 35, 507.
Argyris, C., & Schön, D. A. (1992). Theory in practice: Increasing professional effectiveness (1 ed. 1974, 6. print). Jossey-Bass Publ.
Pfeffer, J., & Sutton, R. I. (2006). Hard Facts, dangerous half-truths, and total nonsense. Profiting form evidence-based management. Harvard business review press.
Pfeffer, J., & Sutton, R. I. (2006). Evidence-based management. Harvard Business Review, 84(1), 62–74.
El problema del performance management no es evaluar (Pulakos, Mueller Hanson, Arad y Moye, 2015). El sistema no está roto porque midamos, sino porque medimos algo que se ha desconectado de aquello a lo que debía servir. La evaluación se ha vuelto trámite (rellenar una casilla, cerrar el expediente) y ha dejado de asociarse a la conducta real que se pretende mejorar. Los que critican la evaluación del rendimiento no son cuatro recién llegados.
Deming (1986) ya metía la calificación anual por méritos entre sus enfermedades mortales, con el argumento de que atribuimos a la persona lo que en realidad produce el sistema. Da igual que hablemos de notas o de incentivos: el premio contingente parece fomentar la motivación extrínseca y erosiona la motivación intrínseca que es justo la que normalmente interesa potenciar. La métrica que sustituye el juicio profesional por un indicador, en cuanto tiene consecuencias, alguien aprende a maquillarla (Campbell, 1979; Strathern, 1997). Murphy (2020) ya escribió hace unos años: “performance evaluation will not die, but it should”.
Todo esto es anterior a la IA. Lo interesante es releerlo ahora porque la IA no ha traído un problema nuevo; ha añadido una capa encima de los de siempre. A los problemas de toda la vida (el sesgo del que evalúa, el trámite, el indicador que se maquilla) se suma ahora el postureo: que lo que evalúo no lo haya escrito quien lo firma, y que la propia evaluación tampoco la escriba quien la firma. El indicador se externaliza a una máquina. Y el filtro que teníamos, afinado durante décadas, no está preparado para esto.
Nuestra evaluación sumativa en la universidad está rota por lo mismo que el performance management. No porque la evaluación sumativa no sirva (sirve, y no voy a discutirlo), sino porque también se ha desconectado. La nota certifica cada vez menos lo que dice certificar, y la IA solo ha hecho visible una desconexión que ya venía de antes.
La tentación fácil es contestar “pues no evaluamos”, “quitamos el filtro” o “esto es demasiado difícil de evaluar, así que no lo evaluamos”. El reto es construir un marco para hacerlo bien, asumiendo que es complejo y que habrá que rehacerlo cuando cambien las condiciones. La dificultad de evaluar nunca ha sido excusa para dejar de evaluar, ha sido el motivo para diseñar mejor.
Es la misma conclusión de Murphy y DeNisi (2023): deshacerse de la evaluación no es la respuesta. Lo que toca es rediseñar, seguramente desde cero, no solo hacer normativas o recomendaciones (Corbin, Dawson, Nicola-Richmond y Partridge, 2025). Significa replantear la evaluación a nivel de programa y de forma colaborativa, algo que Nicola-Richmond, Dawson, Partridge y Macfarlane (2025) describen como un asunto de comunidad, más que de asignatura suelta. O sea, un trabajo enorme. No sabemos todavía cómo hacerlo bien en tiempo de IA, con el agravante de que ahora ni siquiera nos queda el consuelo del filtro viejo que, aunque fuera imperfecto, nos dejaba dormir tranquilos.
Referencias:
Campbell, D. T. (1979). Assessing the impact of planned social change. Evaluation and Program Planning, 2(1), 67–90. https://doi.org/10.1016/0149-7189(79)90048-X
Corbin, T., Dawson, P., & Liu, D. (2025). Talk is cheap: Why structural assessment changes are needed for a time of GenAI. Assessment & Evaluation in Higher Education, 50(7), 1087–1097. https://doi.org/10.1080/02602938.2025.2503964
Craig, P., Dieppe, P., Macintyre, S., Michie, S., Nazareth, I., & Petticrew, M. (2008). Developing and evaluating complex interventions: The new Medical Research Council guidance. BMJ, 337, a1655. https://doi.org/10.1136/bmj.a1655
Deming, W. E. (2000). Out of the Crisis. MIT Press.
Murphy, K., & DeNisi, A. (2023). New approaches to dealing with performance management: Getting rid of performance appraisals is not the answer. IIM Ranchi Journal of Management Studies, 2(2), 143–158. https://doi.org/10.1108/IRJMS-09-2023-0074
Murphy, K. R. (2020). Performance evaluation will not die, but it should. Human Resource Management Journal, 30(1), 13–31. (WOS:000490177200001). https://doi.org/10.1111/1748-8583.12259
Nicola-Richmond, K., Dawson, P., Helen, P., & Macfarlane, S. (2025). It takes a village… Program-wide approaches to redesigning assessment in a time of generative artificial intelligence (GenAI). Journal of University Teaching and Learning Practice, 22(7), e1711–e1711. https://doi.org/10.53761/zpp2ja61
Pulakos, E. D., Hanson, R. M., Arad, S., & Moye, N. (2015). Performance Management Can Be Fixed: An On-the-Job Experiential Learning Approach for Complex Behavior Change. Industrial and Organizational Psychology, 8(1), 51–76. https://doi.org/10.1017/iop.2014.2
Skivington, K., Matthews, L., Simpson, S. A., Craig, P., Baird, J., Blazeby, J. M., Boyd, K. A., Craig, N., French, D. P., McIntosh, E., Petticrew, M., Rycroft-Malone, J., White, M., & Moore, L. (2021). A new framework for developing and evaluating complex interventions: Update of Medical Research Council guidance. BMJ, 374, n2061. https://doi.org/10.1136/bmj.n2061
Strathern, M. (1997). ‘Improving ratings’: Audit in the British University system. European Review, 5(3), 305–321. https://doi.org/10.1002/(SICI)1234-981X(199707)5:3%253C305::AID-EURO184%253E3.0.CO;2-4
Cuando la tecnología avanza en meses y la institución en años
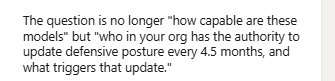
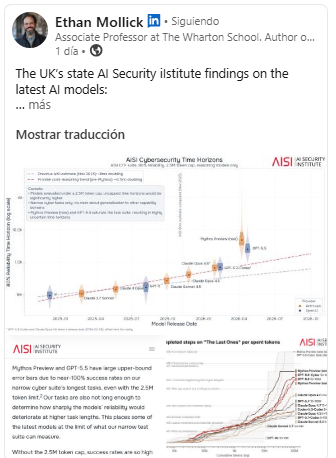
Llevo como 3 años teniendo la intuición de que el modo en que “la gente” aborda el asunto de la IA gen en la universidad no me convence (los tipos de controles que plantean, los enfoques subyacentes, que son prácticamente reactivos, etc.). No sabía hacer explícito por qué me chirriaba tanto, simplemente tenía el síndrome del niño de “El traje nuevo del emperador” del cuento de H.C. Andersen. Hasta hoy. Gracias a este post de Ethan Mollick se me ha encendido la bombillita de por qué no me cuadra. Si pienso en mi universidad como una organización (de las leeeeeentas en reaccionar), donde los cambios requieren muchos meses (o años). No solo porque es pública… es que, sobre todo, es muy grande (trabajan unas 5.000 personas e influyen en los órganos de gobierno los representantes de 35.000), y tiene una cultura débil, o mejor dicho, muchas culturas fuertes incompatibles entre sí, desarrolladas en silos. Entonces, una tecnología que avanza en ciclos de muy pocos meses liberando capacidades nuevas (y casi inimaginables unos meses o semanas antes), que impactan considerablemente en la función y objetivos de la organización, nos lleva a la cuestión clave a la que apunta Ethan y que también le he escuchado a David Roldán Martínez: La pregunta relevante no es “cuáles son las capacidades de los modelos”, sino quién (o quiénes) en la organización tiene la autoridad y la capacidad para revisar, establecer e implementar las medidas de protección (o de aprovechamiento de la oportunidad) cada 4 o 5 meses. Me da la sensación (igual me equivoco) que la gente que conozco está anclada en la primera pregunta. Quizás porque la respuesta a la segunda pregunta es desgraciadamente obvia: NADIE.
Tres años siendo el niño del cuento (y por fin sé por qué)
Esta semana lo he probado yo mismo aplicado al Grado de Ingeniería de Organización Industrial. El jueves voy a ponerlo en práctica con unos 35 asistentes al taller y veremos qué pasa. Hasta ahora solo lo he aplicado a mis propias asignaturas, que no es exactamente una muestra imparcial.
European Commission. Directorate General for Employment, Social Affairs and Inclusion. (2019). ESCO handbook: European skills, competences, qualifications and occupations. Publications Office. atlasTI-ART-639 soft Skills. https://data.europa.eu/doi/10.2767/934956
RESULTADOS–> [en construcción]
Esa metodología me permitirá activar un proyecto atascado sobre soft-skills
Me hubiera gustado hacer esta reflexión sobre una tarea de “management” (gestión), pero no he encontrado material para ello.
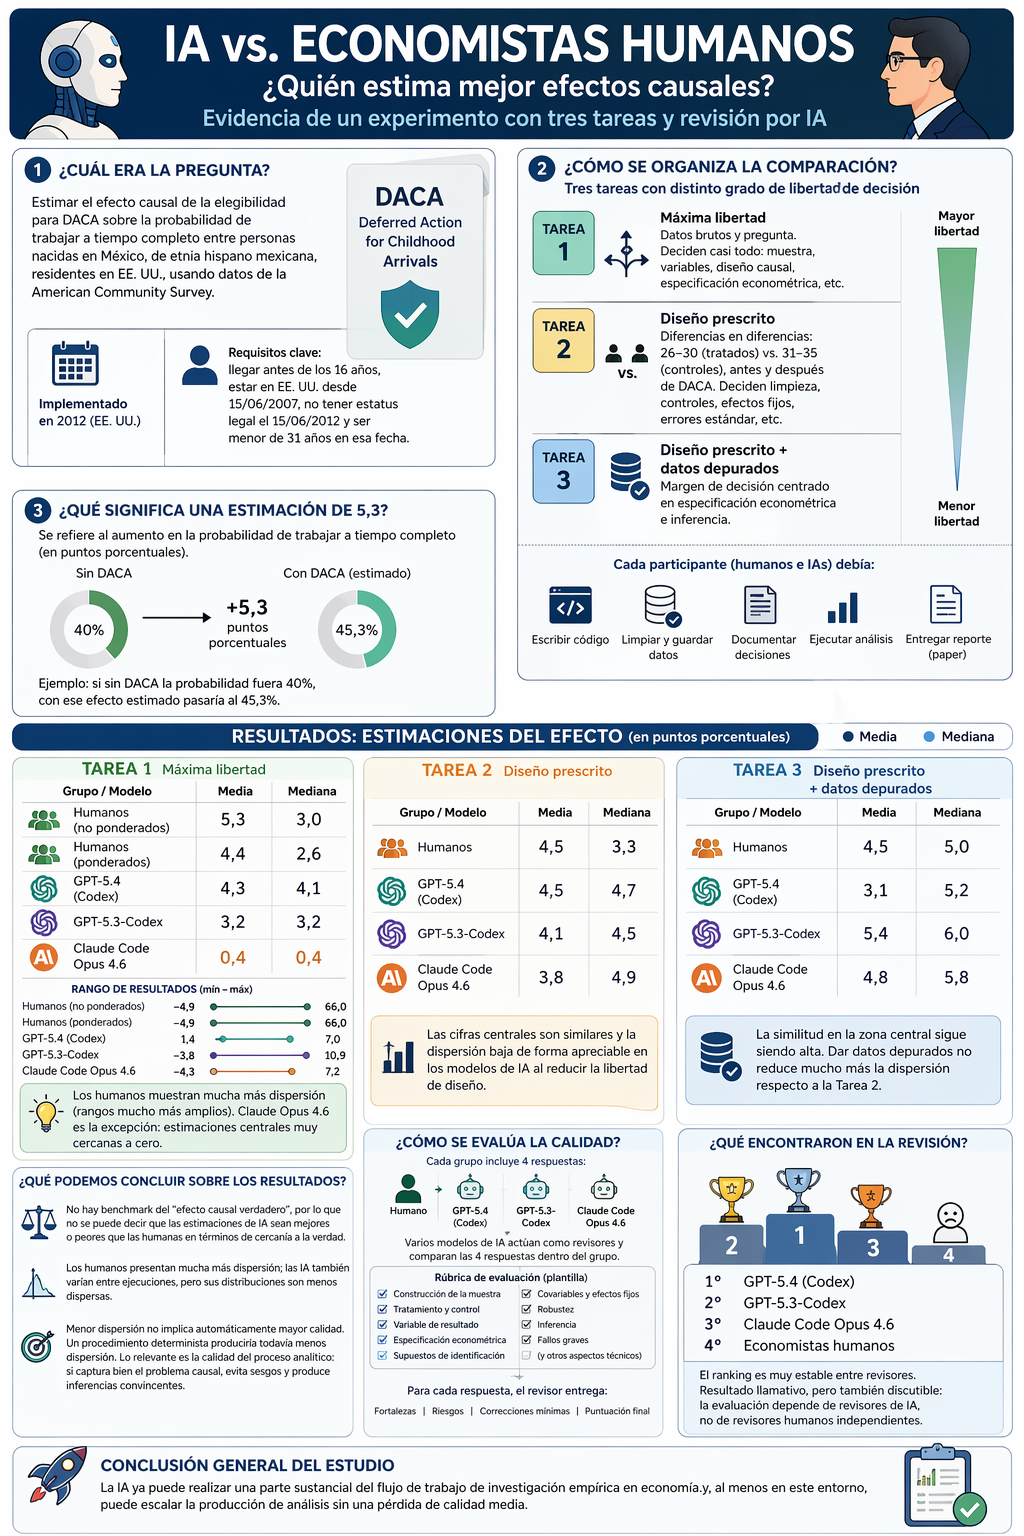
El trabajo que he encontrado compara sistemas de IA con humanos economistas en una tarea real de inferencia causal aplicada. La pregunta era : estimar el efecto causal de la elegibilidad para DACA sobre la probabilidad de trabajar a tiempo completo entre personas nacidas en México, residentes en Estados Unidos, usando datos de la American Community Survey.
DACA es Deferred Action for Childhood Arrivals: un programa de EE. UU. implementado en 2012 que concedía a ciertas personas inmigrantes indocumentadas que habían llegado al país siendo menores una protección temporal frente a la deportación y autorización temporal de trabajo, siempre que cumplieran varios requisitos de elegibilidad. Entre ellos, el artículo menciona haber llegado antes de los 16 años, haber estado en EE. UU. desde el 15 de junio de 2007, no tener estatus legal a 15 de junio de 2012 y ser menor de 31 años en esa fecha
La comparación se organiza en tres condiciones experimentales, con distintas capacidades de decisión. En la Tarea 1, humanos e IAs reciben la pregunta y los datos brutos, y deben decidir casi todo: cómo construir la muestra, qué restricciones aplicar, cómo definir variables, qué diseño causal usar y qué especificación econométrica estimar. En la Tarea 2, el diseño principal ya viene fijado: deben comparar un grupo tratado de personas de 26 a 30 años con un grupo de control de 31 a 35 años, siguiendo una lógica de diferencias en diferencias antes y después de DACA. Aun así, siguen decidiendo aspectos como limpieza de datos, controles, efectos fijos y errores estándar. En la Tarea 3, además del diseño prescrito, reciben un dataset ya depurado, por lo que el margen de decisión se concentra sobre todo en la especificación econométrica y la inferencia.
Esto hace que la tarea se parezca bastante a una investigación empírica real: no solo hay que producir una cifra, sino también traducir una pregunta en un diseño, escribir y depurar código, ejecutar análisis, revisar resultados y entregar un informe de replicación. En cada ejecución de IA, además, cada sistema debía generar código, guardar una versión limpia de los datos, documentar decisiones y producir un reporte en formato de paper. Por eso la tarea se parece bastante al tipo de trabajo que haría un doctorando o un investigador aplicado en economía empírica.
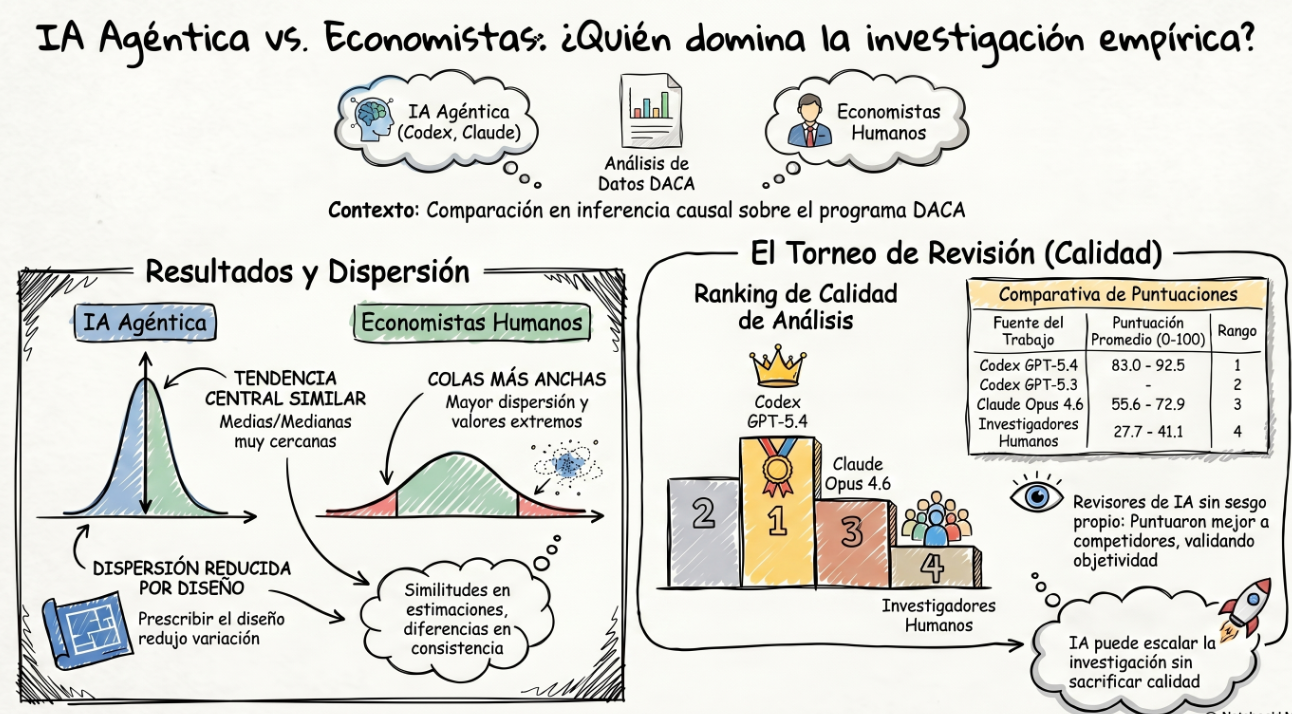
La tendencia central de las estimaciones obtenidas por las IAs y por los humanos es bastante parecida. Las medias humanas suelen ser algo más altas, mientras que las medianas de los modelos de IA suelen ser algo más altas. En la Tarea 1 Claude Code Opus 4.6, tiene estimaciones son bastante menores que las de humanos y que las de los dos sistemas Codex.
Cuando el artículo habla de una estimación de 5,3, se refiere al aumento de la probabilidad de trabajar a tiempo completo. Así, una estimación de 5,3 significa que ser elegible para DACA se asocia con un aumento estimado de 5,3 puntos porcentuales en esa probabilidad. Por ejemplo, si sin DACA la probabilidad fuera del 40%, con ese efecto estimado pasaría al 45,3%.
En la Tarea 1, las estimaciones humanas promedio se sitúan en torno a 5,3 y medianas de 3,0 y 2,6. Entre las IAs, GPT-5.4 obtiene una media de 4,3 y una mediana de 4,1; GPT-5.3-Codex, una media y mediana de 3,2; y Claude Opus 4.6 es una excepción, con una media y mediana de solo 0,4. Es decir, produce estimaciones centrales muy cercanas a cero.
El rango de resultados propuestos por humanos es mucho más amplio que en los modelos de IA:
Humanos no ponderados: mínimo −4,9 y máximo 66,0.
Humanos ponderados: mínimo −4,9 y máximo 66,0.
GPT-5.4: mínimo 1,4 y máximo 7,0.
GPT-5.3-Codex: mínimo −3,8 y máximo 10,9.
Opus 4.6: mínimo −4,3 y máximo 7,2.
En la Tarea 2, los humanos se sitúan en medias de 4,5, con medianas de 3,3. GPT-5.4 da una media de 4,5 y mediana de 4,7; GPT-5.3-Codex, 4,1 y 4,5; y Opus 4.6, 3,8 y 4,9. Aquí el resultado importante no es solo que las cifras sean parecidas, sino que la dispersión baja de forma apreciable en los modelos de IA cuando se les reduce la libertad para elegir el diseño.
En la Tarea 3, con diseño prescrito y datos ya limpiados, la similitud en la zona central sigue siendo alta. Los humanos muestran una media de 4,5, una mediana de 5,0. GPT-5.4 tiene una media de 3,1 y mediana de 5,2; GPT-5.3-Codex, 5,4 y 6,0; y Opus 4.6, 4,8 y 5,8. Proporcionarles un dataset ya depurado no reduce mucho más la dispersión respecto a la Tarea 2.
Este trabajo no permite decir si las estimaciones de la IA son mejores o peores que las humanas en términos de cercanía a una verdad conocida, porque no existe un benchmark del efecto causal verdadero con el que comparar. Lo que sí muestra es que las estimaciones humanas presentan dispersión mucho más amplia, mientras que la IA, aunque también tiene variabilidad ante diferentes ejecuciones, suele generar distribuciones menos dispersas.
Una menor dispersión no debería interpretarse automáticamente como una señal de mayor calidad. Un procedimiento completamente determinista produciría todavía menos dispersión. La cuestión relevante no es solo cuánto varían los resultados, sino si el proceso analítico captura bien el problema causal, evita sesgos importantes y produce inferencias convincentes. En ese punto, el estudio aporta evidencia indirecta, pero no una validación definitiva.
La segunda parte del artículo intenta medir la calidad, no solo las diferencias en los resultados. Para ello, cada trabajo es evaluado por modelos de IA que actúan como revisores y comparan, dentro de un mismo grupo, cuatro respuestas distintas: una humana y tres generadas por IA (una por cada modelo). La evaluación sigue una plantilla , centrada en aspectos como la construcción de la muestra, la definición de tratamiento y control, la variable de resultado, la especificación econométrica, la plausibilidad de los supuestos de identificación, el uso de covariables y efectos fijos, la robustez, la inferencia y la posible existencia de fallos graves. Además, para cada respuesta, el revisor debe identificar fortalezas, riesgos, correcciones mínimas necesarias y una puntuación final. Es decir, es una valoración relativa de la metodológica y técnica de cada análisis frente a los demás. El ranking es muy estable entre revisores: primero Codex GPT-5.4, segundo Codex GPT-5.3-Codex, tercero Claude Code Opus 4.6 y cuarto los investigadores humanos. Ese es probablemente el resultado más llamativo del estudio, aunque también el más discutible, porque la evaluación final depende de revisores de IA y no de revisores humanos independientes.
La conclusión general del trabajo es que la IA ya puede realizar una parte del flujo de trabajo de investigación empírica en economía y que, al menos en este entorno, puede escalar la producción de análisis sin una pérdida de calidad media.
ACLARACION adicional, para no crear falsas ilusiones:
Lo que yo interpreto (igual estoy siendo demasiado crítico con el estudio) es que, si a un algoritmo le pasas una tarea probabilística para realizar, la hará con menos dispersión que si se la pasas a una persona. Punto.
Si la calidad la mides como “adherencia” a las normas o a la rúbrica establecida, un algoritmo jamás será batido por una persona. Punto.
Este trabajo (en mi opinión) no sirve para decir si un algoritmo es mejor que una persona para esta tarea. Sino si un algoritmo funciona como se espera que funcione un algoritmo. Y la respuesta es que sí.
Que el mundo profesional ha cambiado en los últimos años está fuera de toda duda. La pandemia de COVID-19 y la irrupción de la IA generativa se han sumado a otros cambios que ya se estaban manifestando.
En este contexto, creo que es necesario replantear qué competencias/skills necesitamos formar en nuestros graduados. Quizás no sean necesarios cambios (lo dudo); quizás haya que añadir cosas nuevas; quizás algunas cosas hayan pasado a ser obsoletas. Pero no es trivial dar respuesta a las preguntas: ¿debemos actualizar la formación que ofrecemos? ¿en qué sentido?
Llevo casi dos años dándole vueltas a esto, pero aún no he logrado concretar un marco de trabajo. Entre otras cosas, estaba esperando encontrar alguna investigación que explicara cómo ha cambiado el trabajo profesional en algunas profesiones debido al teletrabajo y otras formas de flexibilidad, la inteligencia artificial generativa y demás condiciones actuales.
Hoy he decidido crearme un “framework” que no estoy seguro de que me lleve a buen puerto, pero lo comparto, lo intento poner en marcha y luego os comento si me ha funcionado o no.
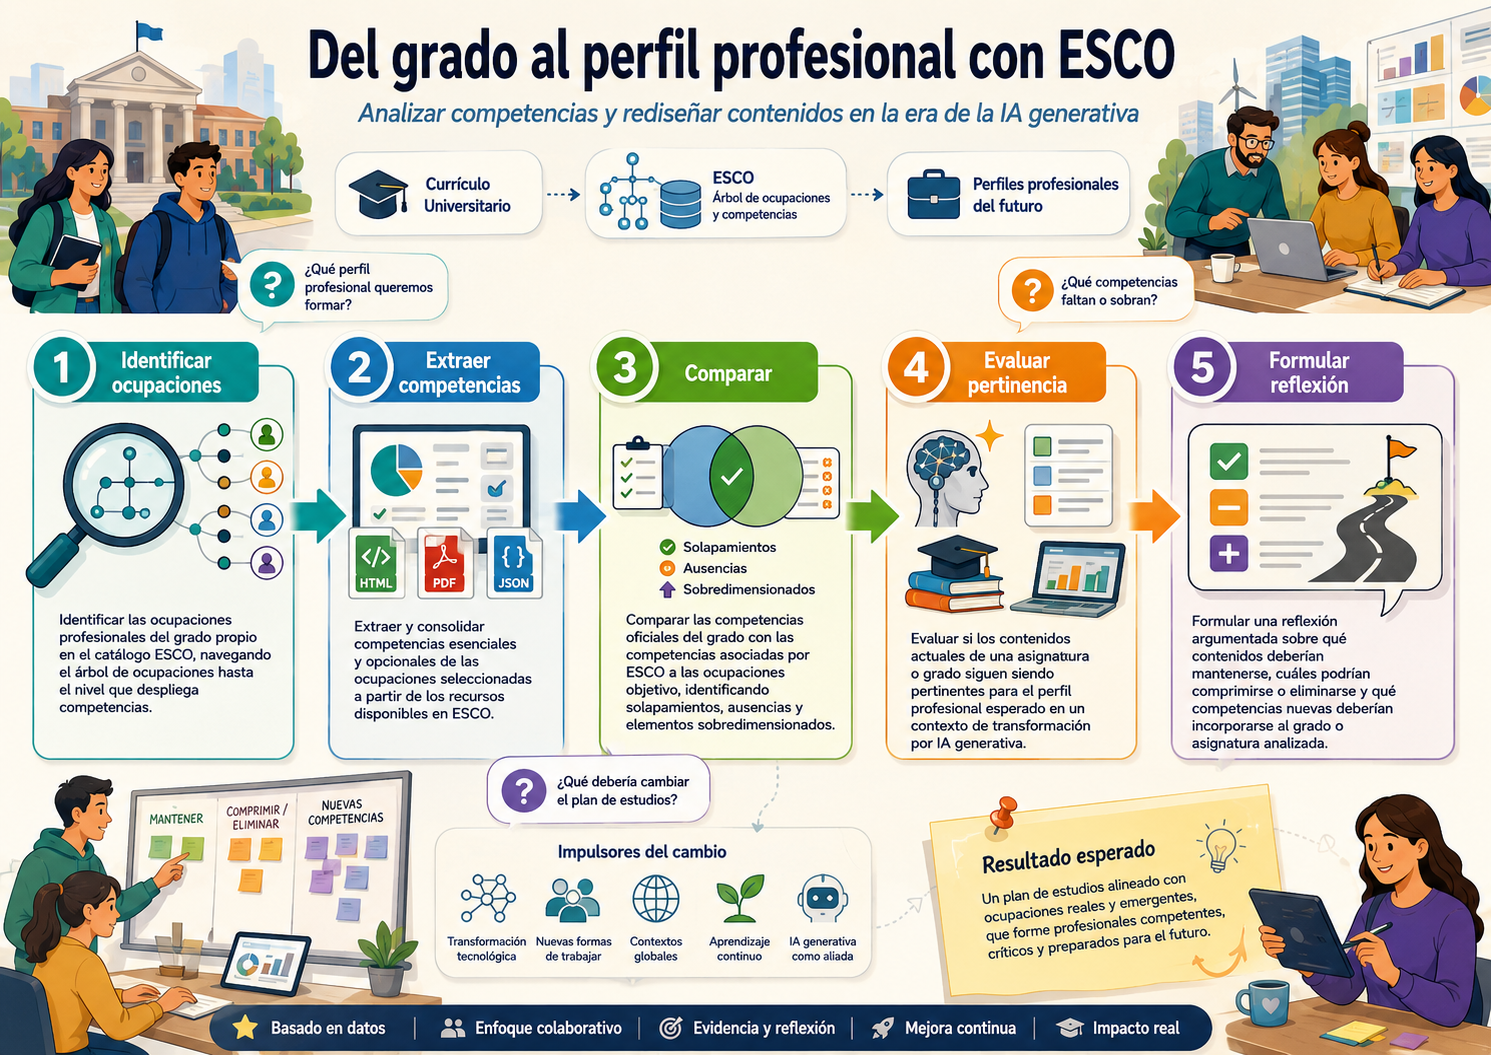
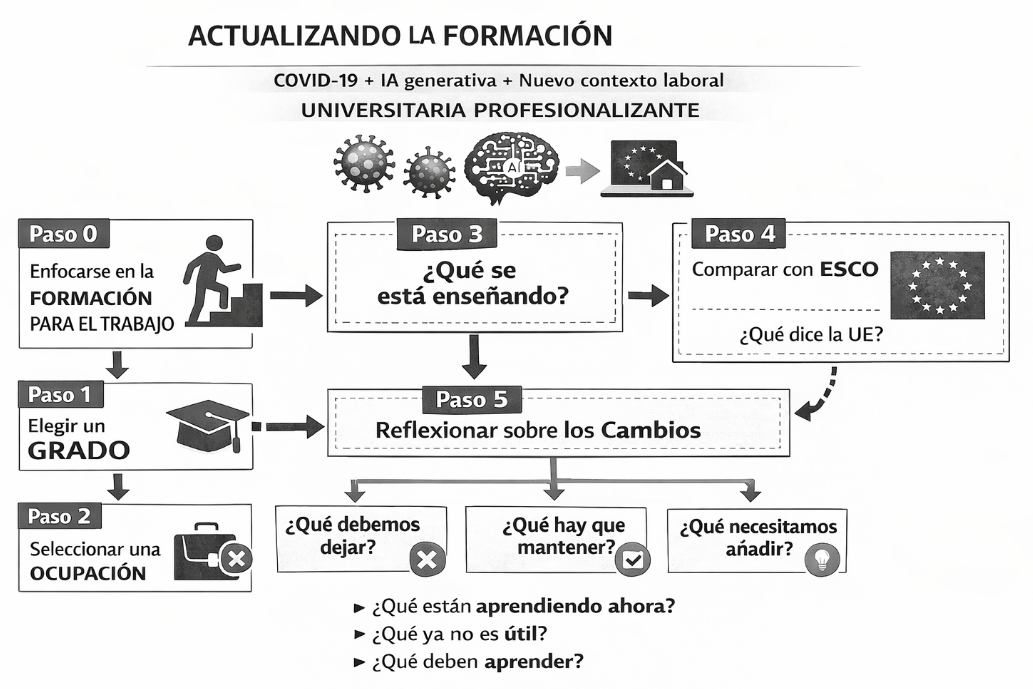
Paso 0. Decido centrarme en la formación para el trabajo y en ver las necesidades de la persona que usará lo aprendido para ser una profesional. Podría haber elegido otro enfoque, pero creo que este me va a resultar más sencillo y luego por abstracción intentar generalizar hacia otros perfiles.
Paso 1. Elegir un grado para centrarme en él.
Pensar en qué cambios son necesarios a nivel global me resulta demasiado complicado, ya que el impacto del nuevo contexto puede ser muy distinto en cada profesión. Igual luego no lo son tantos, pero me ha parecido más sencillo ir de lo particular a lo general que al revés.
Paso 2. Elegir una ocupación dentro de las que se suponen más comunes afines al grado y centrarme en ella, para luego ir abriendo el abanico a algunas ocupaciones parecidas y ver si hay cambios sustanciales.
Paso 3. Identificar cuáles son las competencias en las que estamos formando actualmente. Es un paso sencillo porque la “verdad” es lo que consta en las memorias de verificación de cada título.
Paso 4. Comparar el resultado del paso 3 con las propuestas oficiales de la Unión Europea.
yo he decidido usar como marco de referencia ESCO. Quizás haya otros marcos mejores, pero este es el que conozco y, en teoría, debería ser un marco sólido.
No obstante, las propuestas de ESCO están ancladas en el pasado. En el mejor de los casos, son buenas propuestas para hace 5 años y tendremos que reflexionar si siguen vigentes o no.
Paso 5. Integrar los resultados de los Pasos 3 y 4 y reflexionar sobre qué cambios son necesarios.
La parte de reflexión la tengo un poco débil. En un mundo ideal, donde las empresas supieran de verdad en qué ha cambiado realmente lo que sus profesionales necesitan, el informante relevante sería la empresa. Pero no estoy muy seguro de que haya alguna que tenga la certeza absoluta de qué es lo que realmente necesitan hoy, ni de qué necesitarán dentro de 5 años. Porque la IA generativa (que es el factor de contexto más influyente actualmente) está en pleno “hype” y poca gente puede tener certeza de dónde, cuándo y cómo va a acabar.
Independientemente de quiénes sean los informantes (ya conseguiré aclararme o usar “muestras de conveniencia” o pedir opinión a mis compañeros académicos para que hagamos el diseño desde nuestras “torres de marfil”), las preguntas clave son:
¿Qué están aprendiendo ahora?
¿Qué deberían dejar de aprender porque no es útil?
¿Qué cosas nuevas deberían empezar a aprender porque las necesitarán para ser buenas profesionales?
European Commission. Directorate General for Employment, Social Affairs and Inclusion. (2019). ESCO handbook: European skills, competences, qualifications and occupations. Publications Office. https://data.europa.eu/doi/10.2767/934956
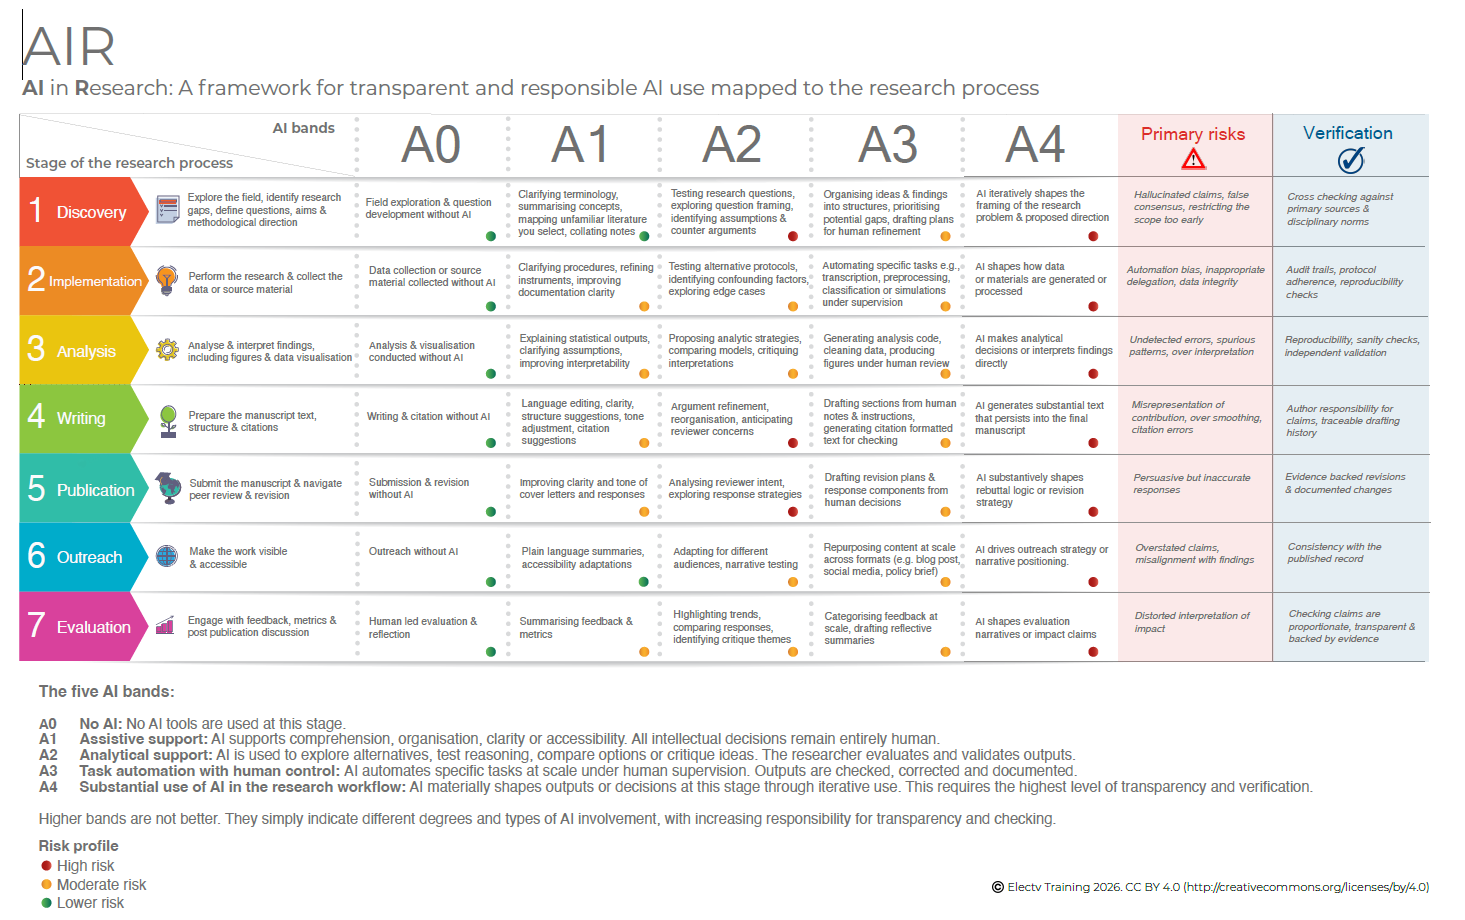
Marco AIR para uso responsable de IA: útil pero revelador de nuestras inconsistencias
Young, J. (2026). AIR: AI in Research – A framework for transparent and responsible AI use mapped to the research process (Version 1). figshare. https://doi.org/10.6084/m9.figshare.31268020.v1
Creo que es muy útil para resolver algunas de las dudas que surgen en mis charlas sobre IA generativa en Research.
Con esta tabla, en menos de 5 minutos, puedes informar con transparencia sobre el uso que has hecho de la IA y las verificaciones que has realizado (la última columna) para estar seguro de que lo etiquetado como riesgo moderado no representa ningún “concern” para la validez de tu trabajo.
Intentar justificar que lo etiquetado como riesgo elevado no te afecta podría dar lugar a un artículo por cada una de las casillas de la columna A4.
Y este es el talón de Aquiles de todo esto… si alguien te obliga a demostrar punto por punto que estás exento de riesgos y sesgos, igual necesitas uno o dos años de trabajo para justificar adecuadamente cualquier artículo… incluso los que has escrito completamente “a mano” sin ayuda de ninguna IA generativa.
Es un poco sorprendente el doble rasero que se aplica, no pidiendo ninguna justificación si lo haces tú solito (proyectando todas tus torpezas y sesgos implícitos), y abrumándote con justificaciones si te apoyas en IA generativa. No, si no está prohibido que la uses, pero si dices que la usas, debes invertir una burrada de horas de trabajo para justificar “adecuadamente” que el uso ha sido correcto.
¿Alguien me ha preguntado alguna vez si he usado correctamente SPSS en los artículos que he escrito en los últimos 30 años? ¡Pero si, las veces que intento adjuntar la sintaxis, los revisores me dicen que quite esa información porque les “despista” y hace innecesariamente largo el artículo!
Young, J. (2026). AIR: AI in Research – A framework for transparent and responsible AI use mapped to the research process (Version 1). figshare. https://doi.org/10.6084/m9.figshare.31268020.v1
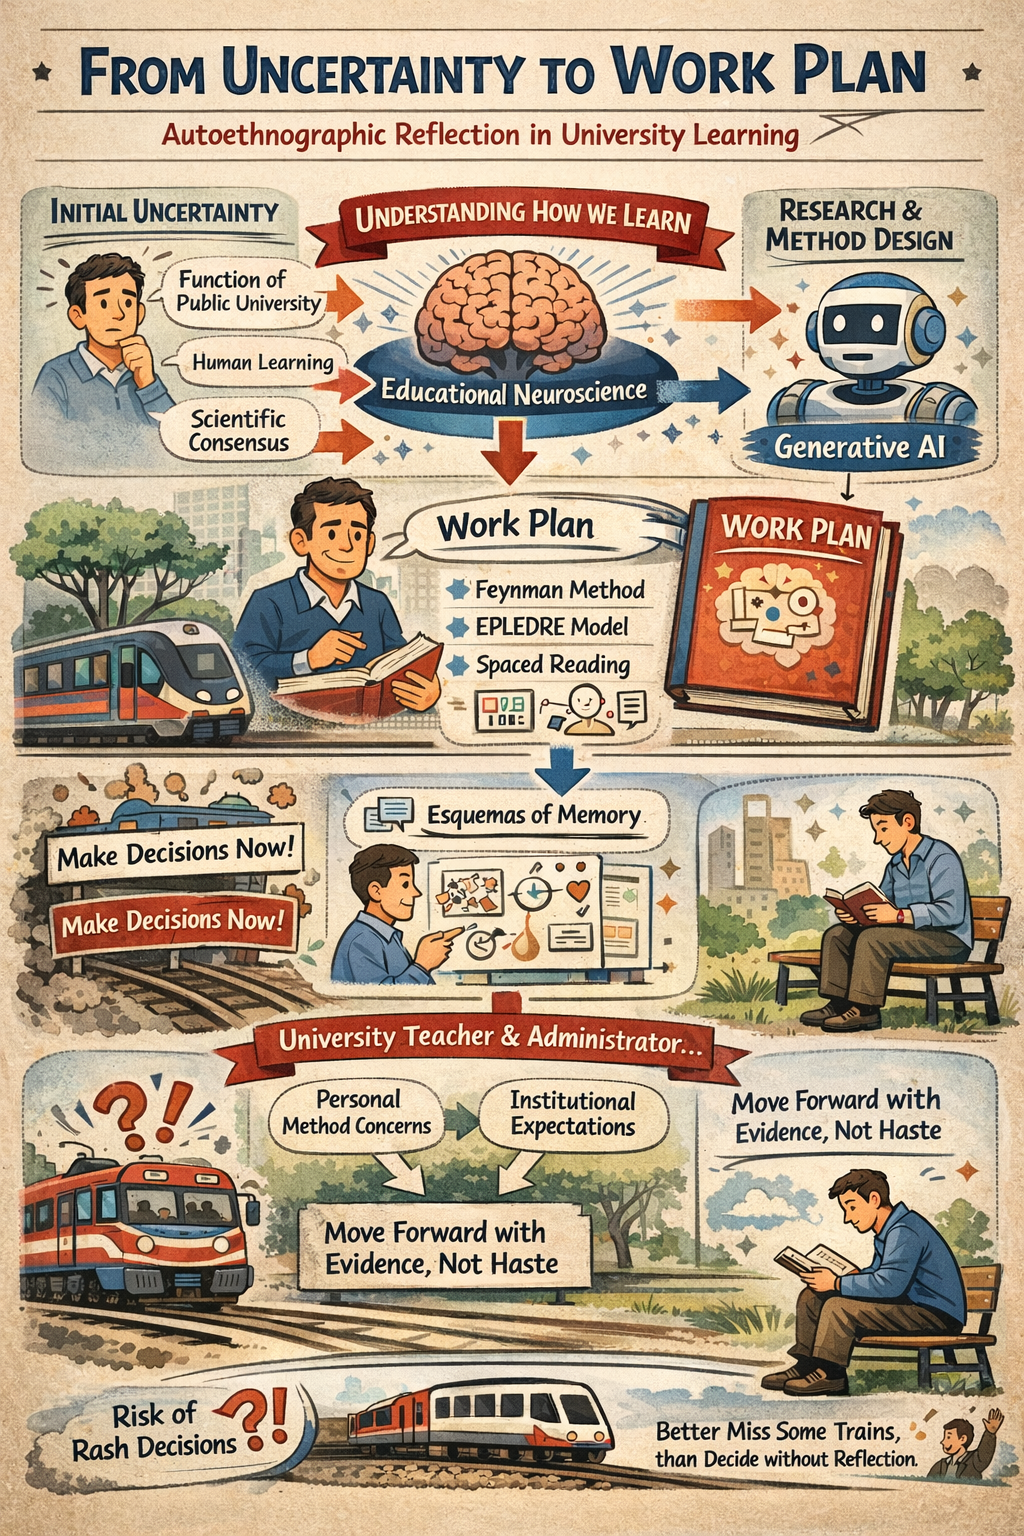
I will be presenting this research at the upcoming XVII International Workshop ACEDEDOT – OMTECH 2026, taking place in Almería, Spain, from March 12-14, 2026:
This communication presents an autoethnographic reflection. Building on four fundamental premises about the function of Spanish public universities and the established mechanisms of human learning, the author documents his personal journey from initial uncertainty to the design of a systematic work plan. The study focuses on understanding the current scientific consensus on how learning is consolidated in the brain and exploring the possibilities of generative AI to enhance this process in the university context. Drawing on the work of Héctor Ruiz Martín, a work plan is designed that combines recommendations from educational neuroscience with the Feynman method and the EPLEDRE model, including spaced reading, creation of sketchnote-type graphic schemes from memory, and public communication of the knowledge constructed. The communication shares the first graphic schemes developed and reflects on the author’s dual position as university teacher and administrator, facing both his own methodological uncertainties and institutional expectations for strategic guidance. It questions the “collective panic” surrounding the emergence of generative AI in universities and the pressure to make quick decisions without sufficient reflection. It proposes replacing reactive urgency with a deliberate process of calm, evidence-based reflection and pilot experimentation, recognizing that in contexts of accelerated change, it is preferable to miss some “trains” rather than make biased decisions under collective amygdala hijacking
Los LLM son aduladores y lisonjeros por naturaleza, tienes que pedirles que sean críticos o “destructivos” para intentar que hagan análisis más ecuánimes. Pero nunca tendrás la seguridad de que te detecten todos los errores o te manifiesten abiertamente todas las cosas negativas, sobre todo si están analizando una propuesta que es un bodrio sideral
Los LLM no tienen memoria a largo plazo. Cada plataforma tiene estrategias distintas para lidiar con el problema de superar la ventana de contexto. ChatGPT usa un FIFO (que, si estás conversando de manera iterativa profundizando sobre el mismo concepto, te da buen resultado porque realmente lo que importa es lo último en lo que estás trabajando). Claude hace “borrón y cuenta nueva”, pero antes, cuando detecta que se queda sin contexto, compacta la conversación (y la documentación subida), la guarda, inicia una nueva instancia y coge como punto de partida el resumen y, a partir de ahí, empieza a trabajar de nuevo. La forma en que trabaja CLAUDE es exactamente el modo que yo trabajo cuando tengo tareas con tiempo fragmentado (Que no puedo completar en una sesión de trabajo), por eso supongo que me gustan más los resultados que me da Claude que los de ChatGPT
Además de lo anterior, el uso de Skills y Agents permite aliviar el problema de la memoria de contexto. Solo se activa lo que necesitas para una tarea y, además, puedes activar “hilos” en paralelo (cada uno con su propia memoria de contexto libre para ese hilo) que se comunican entre sí (los resultados de unos son las entradas para otros). Es una forma modular y analítica de resolver tareas (algo que yo también hago de manera natural: divido en subtareas que me caben en tiempo fragmentado y guardo la “preparación” intermedia para alimentar otras tareas)
He tenido que rebuscar un poco para clarificar los conceptos de skill y agent, este es mi resumen:
Skill (instrucciones/prompts y herramientas para realizar una tarea concreta)
Instrucción: descripción de cuándo usar el skill (ej. “Usa esto cuando la usuaria pregunte por X”)
Herramienta: un trozo de código, una API o una función (ej. buscar en Google, calcular una hipoteca)
Agent (deciden (razonar, planificar) qué herramienta usar, en qué orden las usan y qué hacer si algo sale mal). Puedes activar varios agentes en paralelo
Sigue un ciclo o un proceso: Analiza la meta: “¿Qué me han pedido?”; Planifica: “¿Qué pasos necesito y qué Skills debo usar?”; Ejecuta: Usa una Skill; Observa: “¿El resultado es lo que esperaba?”; Itera: Repite hasta terminar
Imagen generada con Gemini nano bananaImagen generada con ChatGPT5.2
He leído varios blogs estos días donde me ha parecido que sus autoras-es se quejaban de que los “copilotos IA” están mal diseñados y que son los culpables de todos los malos usos que se les están dando. Igual no es lo que querían decir, pero es el mensaje que me ha calado.
Esto me ha llevado a dos reflexiones:
Mejor llamarle herramienta porque no es un copiloto, por mucho que sus desarrolladores quieran denominarlo así porque vende mejor o más
El problema no es del “copiloto”. El problema es del piloto. Si el piloto decide estrellar el barco contra el iceberg, no es problema del barco ni del iceberg. Las tecnologías no son «neutras», eso es cierto, pero el uso (o no uso) que decide darles cada persona es lo que determina el impacto.