La UAB publicó a principio de 2026 un informe sobre absentismo con 3.045 participantes de sus trece centros.
Olmos, P., y Márquez, D. (inv.); Vila, L. (col.); Muñoz, J. L. (coord.), y Badillo, E. (coord.). (2026). L’absentisme a les aules universitàries de la UAB. Per què val la pena anar a classe. ICE, Universitat Autònoma de Barcelona. https://ddd.uab.cat/record/327188?ln=es
Creo que el fenómeno no es nuevo (quizás lo llamativo es el volumen). Ya hace muchos años comentaba con mis compañeros la anécdota de exalumnos que decían que “la universidad no aportaba nada” (y luego se jactaban de haber aprobado sin ir a las clases, ni al campus). Efectivamente, si no participas de la experiencia universitaria, tu paso (de pasar) de la universidad no ha dejado ningún poso en ti.
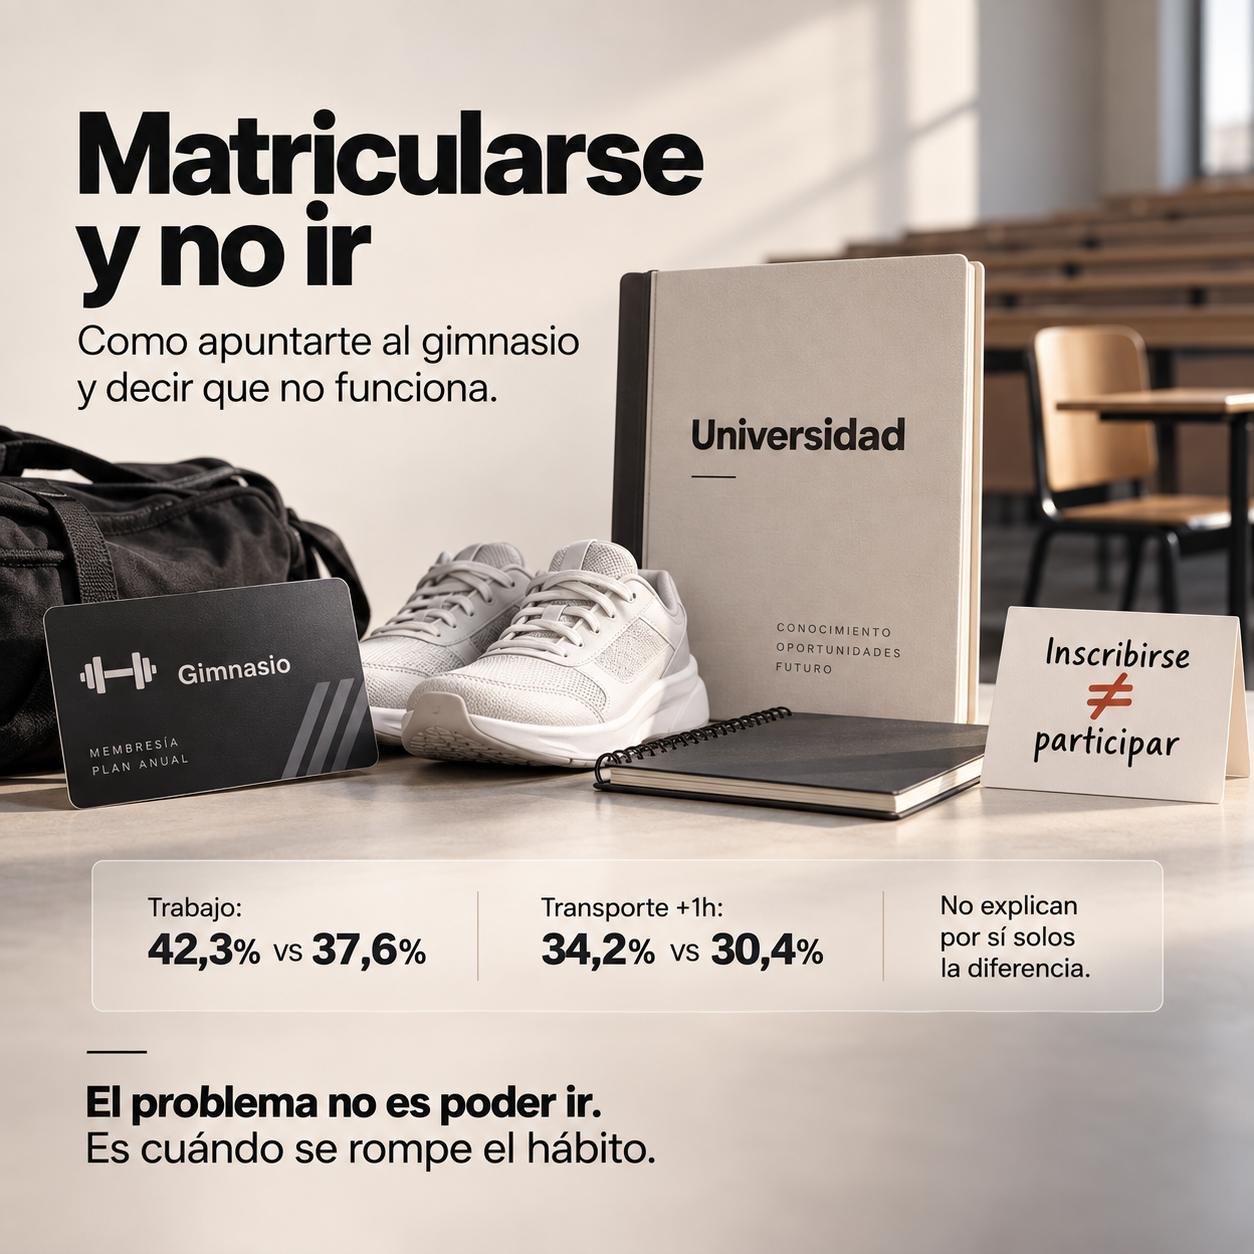
Es como si te matricularas en un gimnasio, luego no fueras y dijeras que el gimnasio no sirve para nada. ¡Obvio, bro!
El ejemplo del gimnasio/deporte me gusta, porque conozco mucha gente de mi edad que me dice “no sé por qué te machacas tanto haciendo deporte, total estamos igual tú y yo”. En la superficie, seguro, incluso más guapos y jóvenes algunos (sobre todo los que se han hecho un implante de pelo). Pero las procesiones van por dentro. Y con la formación universitaria, igual.
Los condicionantes estructurales están presentes (trabajo, transporte, etc.), pero apenas separan a quien asiste de quien no. En la tabla comparativa, entre los que han dejado de asistir a alguna asignatura, trabaja el 42,3 % y entre los que no, el 37,6 %; tardan más de una hora en llegar al campus el 34,2 % frente al 30,4 %. Lo que sí discrimina es repetir asignatura y el curso, porque los de primero asisten más. Es decir, las condiciones de vida complicadas las tiene casi todo el mundo y eso no les impide asistir a clase. El problema no es quién puede ir, es en qué momento se rompe el hábito y por qué nadie lo nota hasta que es irreversible.
Eso se relaciona con un proyecto de escritura que tengo en curso donde queremos analizar qué es lo que hace a una clase presencial insustituible.
Te comparto un flujo de trabajo para poder trabajar con ATLASti (que me resulta muy comodo para análisis cualitativo) y convertir los resultados en el formato de tabla acordado con tu equipo de trabajo, si no quieren tablas en formarto pseudo-long (que es como lo saca Atlas-ti)
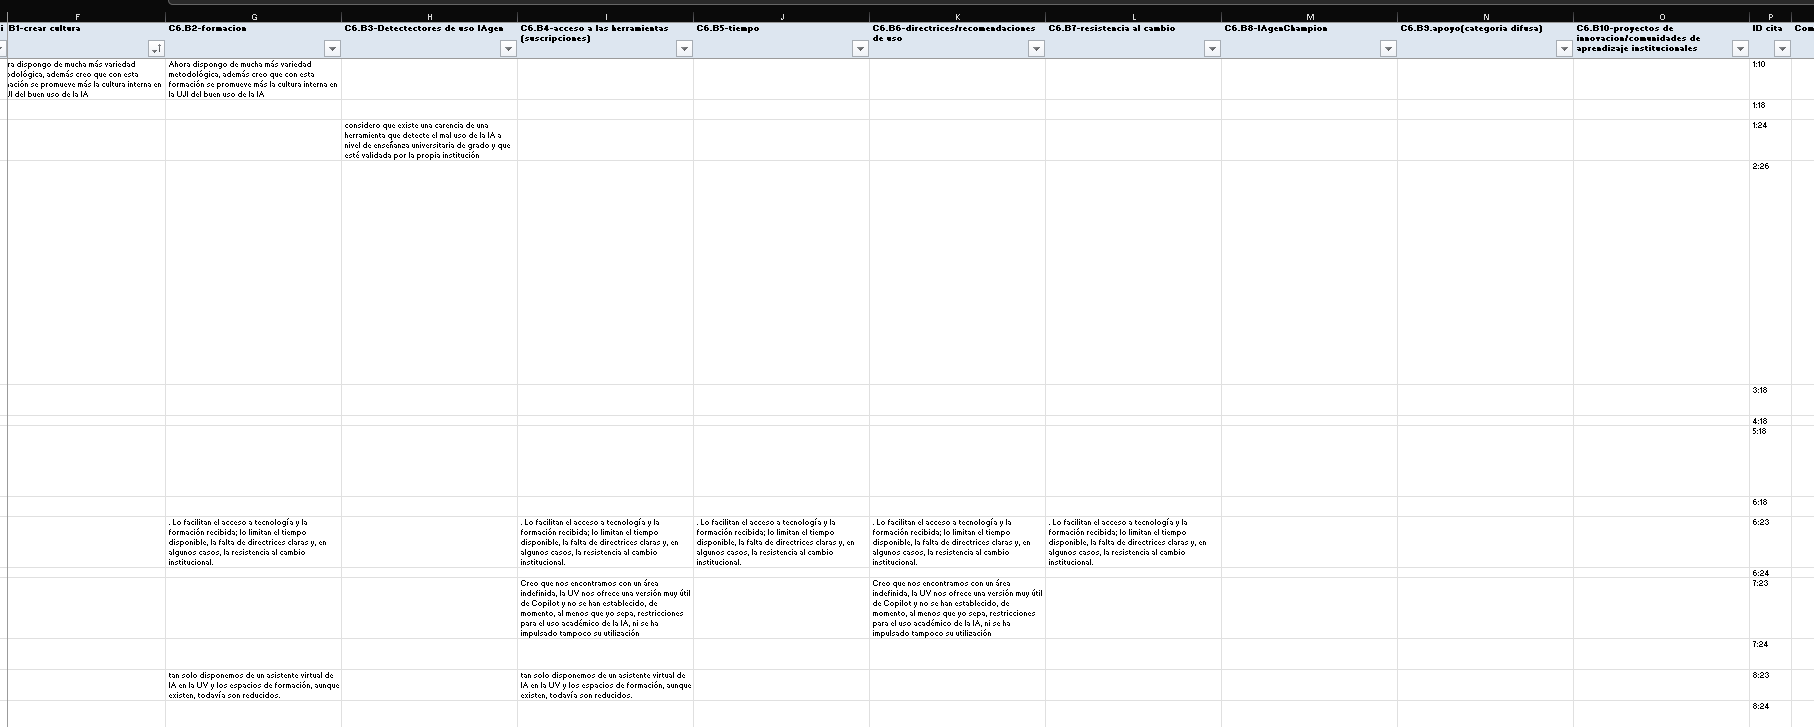
En la reunión de mi grupo acordamos un formato de matriz de este estilo (wide): una fila por cita, una columna por código, y el texto de la cita colocado en la columna que le toca.
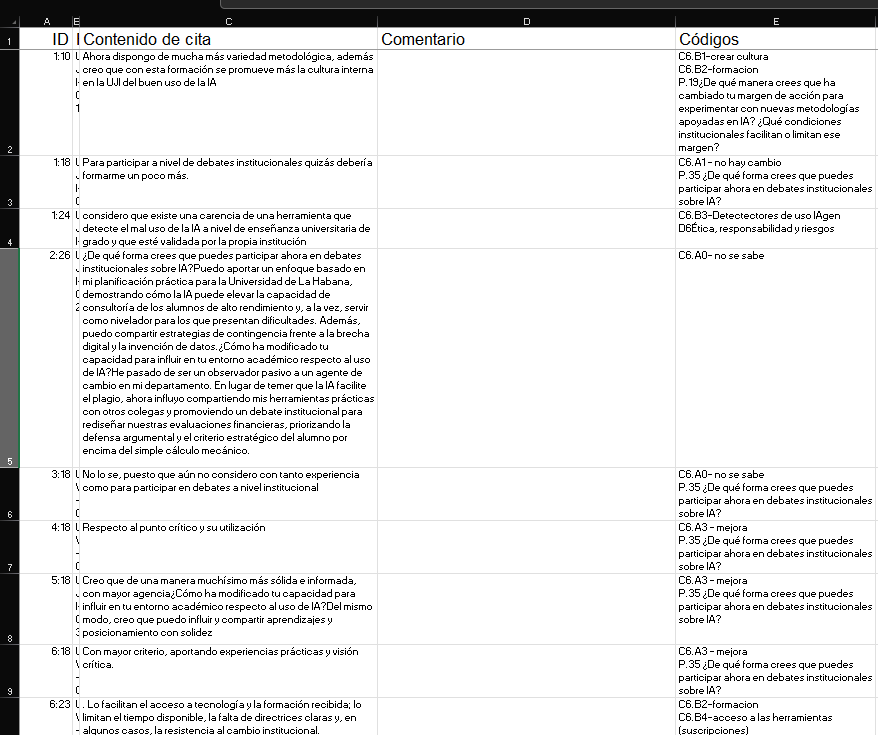
Lo que exporta ATLAS.ti es una fila por cita con un campo multivalor: todos los códigos concatenados dentro de una celda separados por saltos de línea. Eso incumple la primera forma normal (los valores no son atómicos), así que técnicamente es una tabla no normalizada. En el vocabulario de tidyverse se le suele llamar campo anidado o colapsado, que es lo que deshace separate_rows() o unnest(). El formato “long” de verdad sería una fila por par cita-código, sin repetir el texto en columnas.
De modo que me he creado uin script de python que genera el formato wide requerido, (una matriz de incidencia cita × código, one-hot salvo que, en lugar de un uno, lleva el texto de la cita como carga. Este formato no es tidy (pero es el que acordamos). Es justo el contraejemplo canónico de Wickham: las 21 cabeceras de columna son valores de una variable (el código), no nombres de variables.
La versión tidy, que además coincide con la primera forma normal, es precisamente el long intermedio de una fila por par cita-código, con columnas ID cita, fuente, texto y código. El script lo construye y saca como hoja adicional. Así que la cadena real es: anidado → long/tidy → matriz wide.
El flujo es muy simple:
Se codifica en ATLAS.ti, que es donde tiene sentido hacerlo porque es donde están el libro de códigos, los memos, los grupos de códigos y la posibilidad de filtrar por lo que te interese (en mi caso, las citas codificadas con cualquier código de las familias C6.A o C6.B).
Se exporta el informe de citas a Excel, que sale en formato largo: una fila por cita con el identificador, la fuente, el texto, el comentario y todos los códigos apilados dentro de una misma celda separados por saltos de línea.
Y ahí es donde entra un script de Python de poco más de cien líneas que lo transpone al formato que acordamos, añadiéndolo como hoja nueva en el mismo libro para que quede la traza entre el export original y la matriz derivada.
Mi export tenía 97 citas, 54 fuentes y 21 códigos distintos, con 162 etiquetas en total (la mayoría de las citas llevan una o dos, alguna llega a cinco). El script imprime al terminar estas cifras, etiquetas en origen frente a celdas rellenas en la matriz, y si no coinciden, es que algo raro ha pasado. Es el tipo de comprobación que cuesta tres líneas de código y te ahorra descubrir el problema cuando ya llevas media tabla de contingencia calculada.
Un par de detalles que no son obvios hasta que te los encuentras. Ordenar los códigos alfabéticamente te coloca C6.B10 justo detrás de C6.B1, así que hay que ordenar por familia y número. ATLAS.ti mete dentro del texto de algunas citas un carácter separador de párrafo (U+2029) que Excel muestra como un cuadradito y que conviene traducir a salto de línea normal.
El script falló en el primer intento con un ModuleNotFoundError porque VS Code había decidido ejecutarlo con el Python que viene empotrado dentro de Inkscape. No en el mío, que está instalado en D:. En los notebooks eliges el kernel y lo ves; en un .py el intérprete está escondido en la barra de estado y no te enteras hasta que revienta.
Lo he montado con Claude, que es lo que hace que esto pase de “algún día lo automatizo” a estar funcionando en la misma tarde.
El script está en un repositorio público (pipeAtlasti-Excel, bajo AGPL-3.0) por si a alguien le sirve, aunque está bastante atado a mi esquema de códigos. La función que ordena las columnas es el único sitio que habría que tocar para adaptarlo.
El formato de matriz decidido es cómodo para revisar la codificación a ojo y para las tablas de frecuencias, pero para casi cualquier análisis posterior el formato largo es mejor punto de partida. Sospecho que dentro de dos reuniones habremos acordado volver al formato del que venimos…