The Question Behind the Questions: A Practical Guide to Evidence-Based Management

It is very easy to confuse good interview questions with good Evidence-Based Management questions. They are related, but they are not the same thing. An interview question is something you ask one person about their own experience:

  • Do you feel that your supervisor listens to your suggestions?
  • What usually happens when a machine breaks down during your shift?
  • Why do you think people leave this department?
  • Do you find the new scheduling system useful?

These can all be excellent questions. They may generate rich information, examples and stories. But they are still questions designed to collect data from individual respondents.

A management question operates at a different level. It asks what we want to understand once we combine evidence from several people, teams, sites, documents or studies.

For example:

To what extent do employees perceive that their improvement suggestions are taken into account, and what organizational factors influence that perception?

Or, in an operations context:

What factors are associated with recurring production disruptions, and how do operators and supervisors perceive the effectiveness of the current response process?

The difference may look subtle, but it matters.

A simple test:  Could a single interviewee give me the answer? If the answer is yes, you probably have an interview question. If answering the question requires gathering evidence from several people, comparing experiences, identifying patterns, or combining interview evidence with other sources, then you are much closer to a management question. This distinction is particularly useful for junior professionals because, in practice, they are often given broad assignments such as:

  • Find out why productivity has fallen.
  • Understand why people are leaving.
  • See whether employees are really involved in continuous improvement.
  • Investigate why the new process is not working.

The temptation is to immediately prepare a long list of interview questions. But before doing that, it is worth deciding what you actually want to know.

Start from the interview questions, but do not stop there

You do not need to discard the questions you have already written. Instead, group the questions that appear to explore the same underlying phenomenon. Imagine, for example, that you are analysing employee participation in an operations team. You may have drafted questions such as:

  • What happens when an operator identifies an improvement opportunity?
  • How can employees submit improvement ideas?
  • Who decides whether an idea is implemented?
  • Can you remember an occasion when an employee’s suggestion resulted in a real change?
  • Do people receive feedback about the ideas they submit?

These are useful interview items. But together they point towards a broader question:

How do employee participation channels operate in practice, and to what extent do employees perceive that their suggestions lead to meaningful action?

That is the question that gives coherence to the interviews.

The same logic applies in people management. Suppose you are trying to understand voluntary turnover in a department. Your interview guide may contain questions about workload, supervision, promotion opportunities, scheduling, recognition, and team relationships. The management question might instead be:

What factors do employees and line managers associate with voluntary turnover in this department, and which of these factors appear consistently across different roles or teams?

Now the project has a clearer analytical purpose. You are not simply collecting twenty individual stories. You are looking for patterns, differences, and plausible explanations.

A good management question defines the scope of the problem

In the CEBMa approach, a useful Evidence-Based Management question normally makes several things reasonably explicit.

  • First, who or what are we talking about?
    • Employees? Front-line supervisors? Maintenance teams? Production plants? Knowledge workers? Newly hired employees?
  • Second, what phenomenon are we interested in?
    • Absenteeism, employee voice, turnover, implementation of standard work, quality problems, safety behavior, workload, coordination between departments, and adoption of a new technology?
  • Third, what do we want to know about it?
    • How frequently does it occur?
    • How does the process operate?
    • How do people experience it?
    • What factors appear to influence it?
    • What consequences does it have?
    • What interventions seem to improve it?
  • And if a comparison is important, include that comparison explicitly.

For example:

How does perceived workload differ between production and support teams, and what organizational factors are associated with those differences?

Or:

How do highly standardized production units differ from less standardized units in the way operators report and resolve process deviations?

Once the comparison appears in the question, it becomes much harder to forget that you need to collect the corresponding information.

Why this matters in real organizational projects? The quality of the management question affects almost everything that follows. A vague question often produces a vague evidence-gathering exercise. You interview many people, collect dozens of interesting comments, and eventually discover that the material is difficult to synthesize because different interviews were actually exploring different issues. A clearer question helps you decide:

  • Whom you need to interview;
  • What information do you need to collect;
  • Which comparisons are relevant;
  • What additional organizational data may be useful;
  • What external research evidence you should look for.

Consider an operations problem such as recurring delays.

If the question is simply:

  • Why are there delays?

the investigation can quickly become unmanageable. But suppose you formulate it as:

  • What are the main sources of recurrent scheduling delays in the assembly process, and how consistently are these causes identified across operators, supervisors and production data?

That question immediately suggests several sources of evidence. You may need interviews with operators and supervisors, but you may also need downtime records, production schedules, quality data or process observations.

That is an important feature of Evidence-Based Management: interviews are one source of evidence, not necessarily the whole evidence base.

Do not confuse a long interview guide with a sophisticated research design. Junior professionals sometimes worry that having only one or two management questions makes a project look too simple. Usually the opposite is true. A well-defined management question can require many interview items, several evidence sources and substantial analysis. For example, one question about employee involvement in continuous improvement may require you to explore:

  • Access to participation channels
  • Managerial response
  • Psychological safety
  • Feedback mechanisms
  • Implementation rates
  • Perceived fairness
  • Differences between departments
  • Examples of successful and unsuccessful suggestions

Those are not eight separate management questions. They may simply be different aspects of one phenomenon that need to be examined carefully. This is why one or two strong questions are often enough. If you end up with ten “research questions,” there is a good chance that some of them are actually interview questions in disguise.

The practical shift

For someone starting a career in Operations Management or People Management, I think the most useful change in mindset is this:

Do not begin by asking, “What questions should I ask people?”

Begin by asking “What do we need to understand in order to make a better management decision?”

Then decide what evidence would help answer that question. Some of that evidence may come from interviews. Some may come from organizational data. Some may come from scientific research. Some may come from professional expertise or stakeholder concerns.

The interview guide comes later.

Moving from questions to ask individuals to questions the organization needs evidence to answer is one of the most important steps in turning an informal investigation into an Evidence-Based Management process.
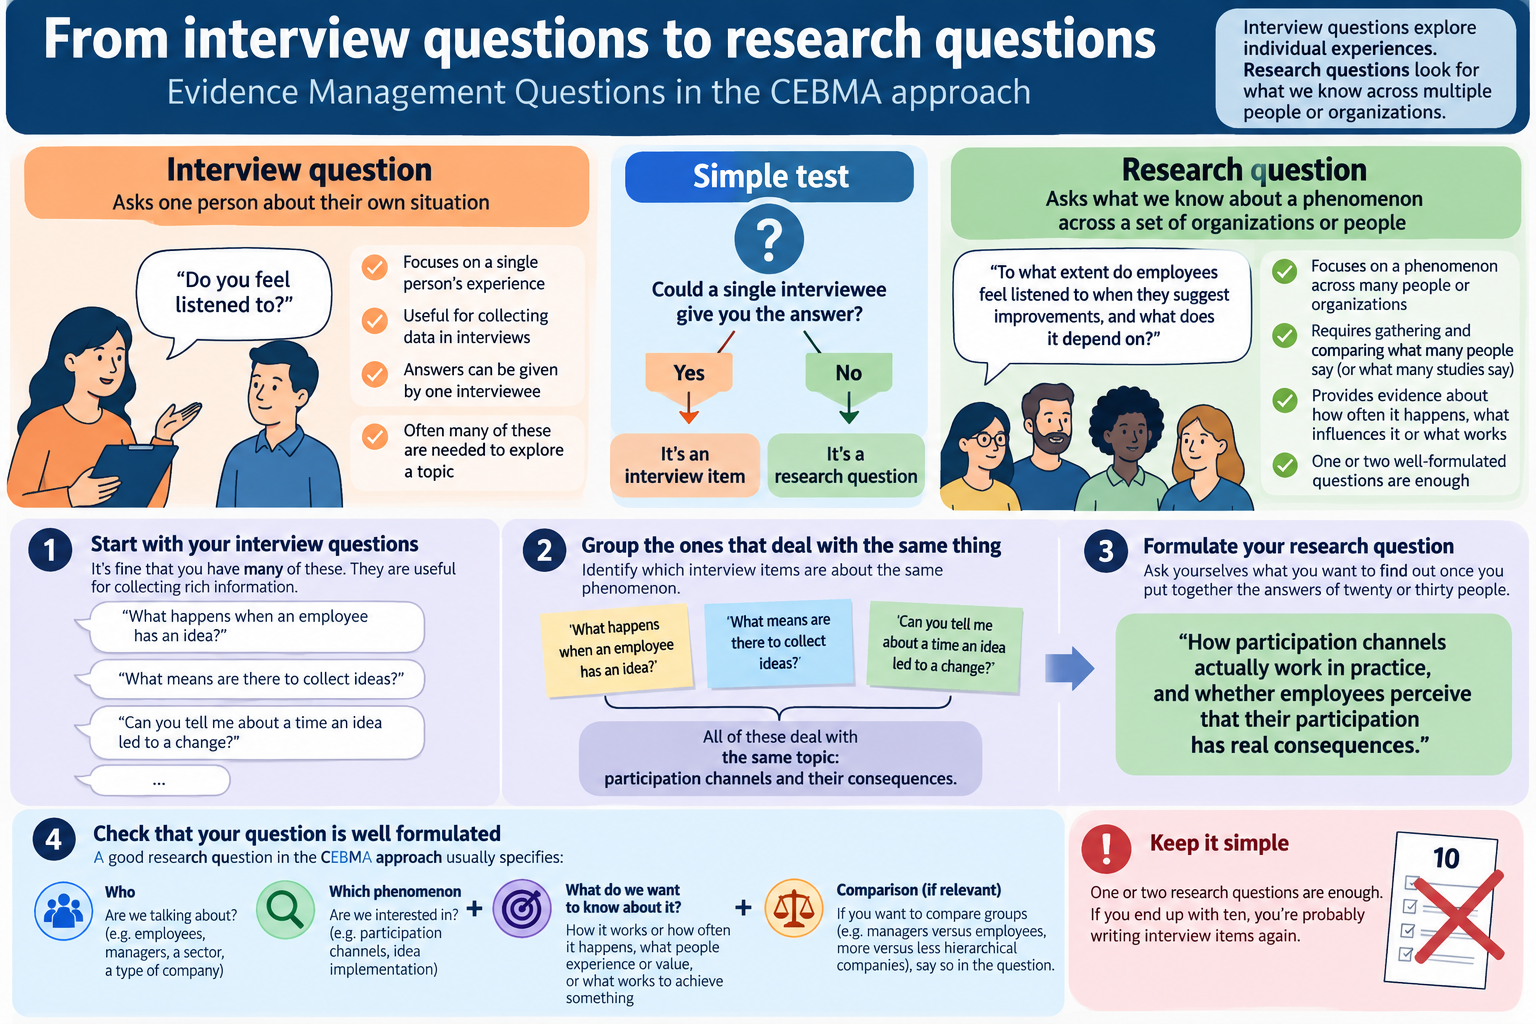
CEBMa approach to EBMquestions. The key distinction is simple: an interview question asks one person about their experience; a management research question asks what we can learn by combining evidence across people, organizations, or studies.
© Juan A. Marín-García (2026) DOE-UPV-ROGLE-IEMAWith the support of the PIME/25-26/544 [Investigación acción para el diseño de los materiales, protocolo y análisis de viabilidad de una intervención compleja para analizar el impacto en la mejora del pensamiento crítico y el uso del marco de referencia del triple diamante en la toma de decisiones en grupo]. Universitat Politecnica de Valencia.

Universitat Politècnica de ValènciaROGLE, Reengineering Operations GroupWork Logistics Excellence

Visitas: 3

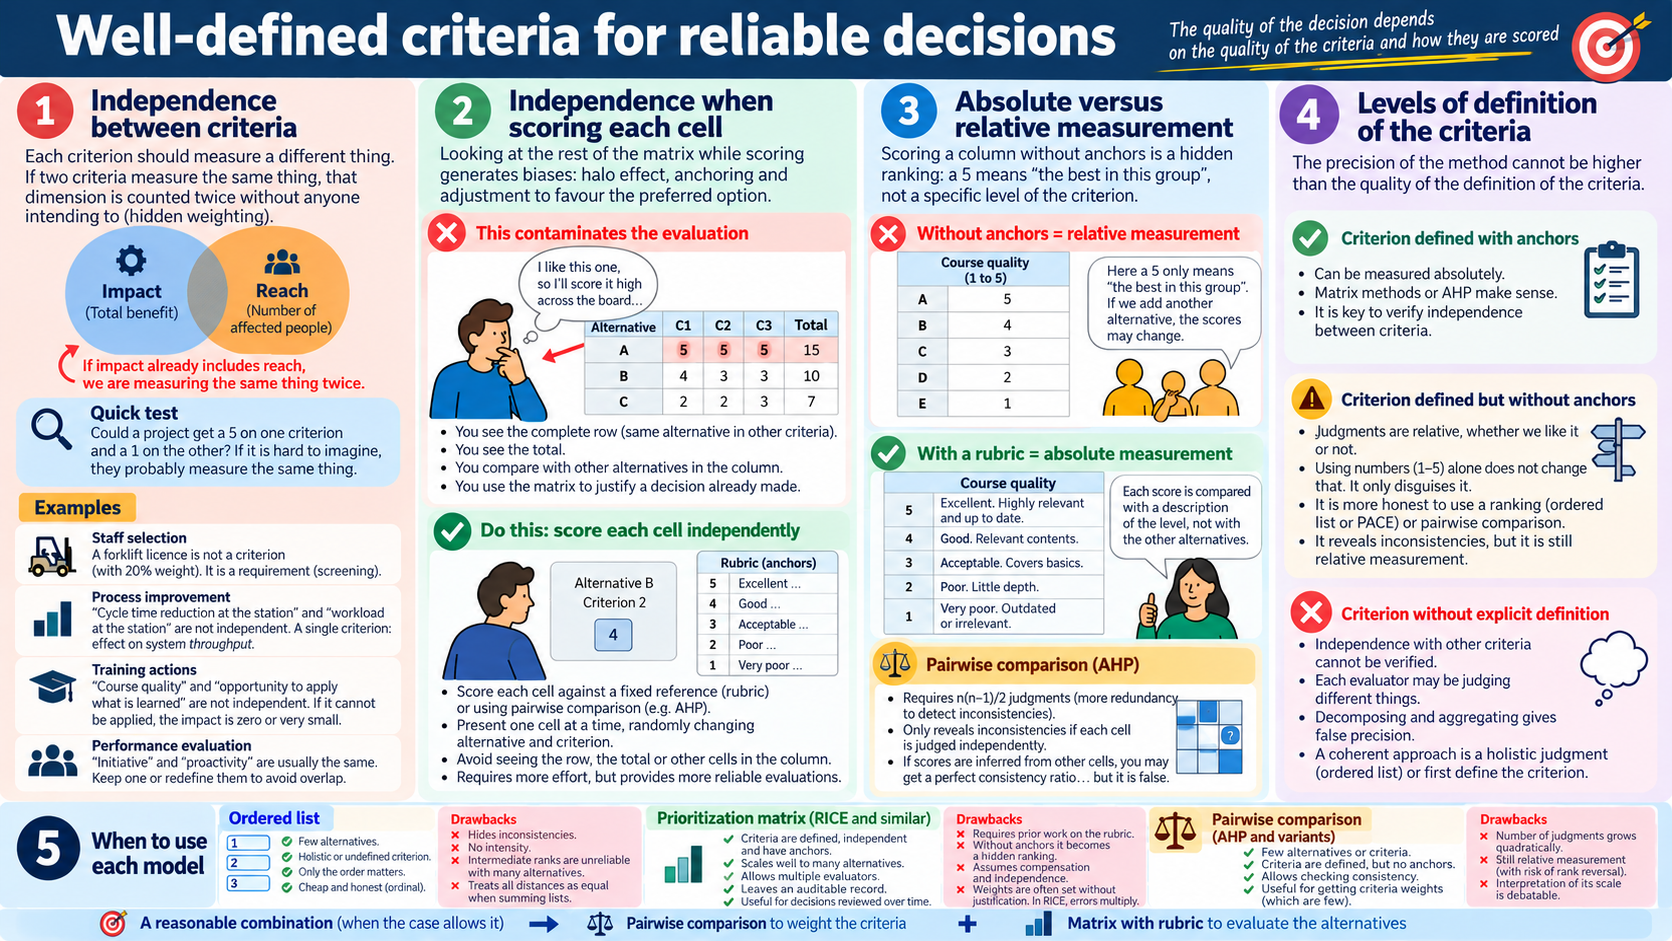
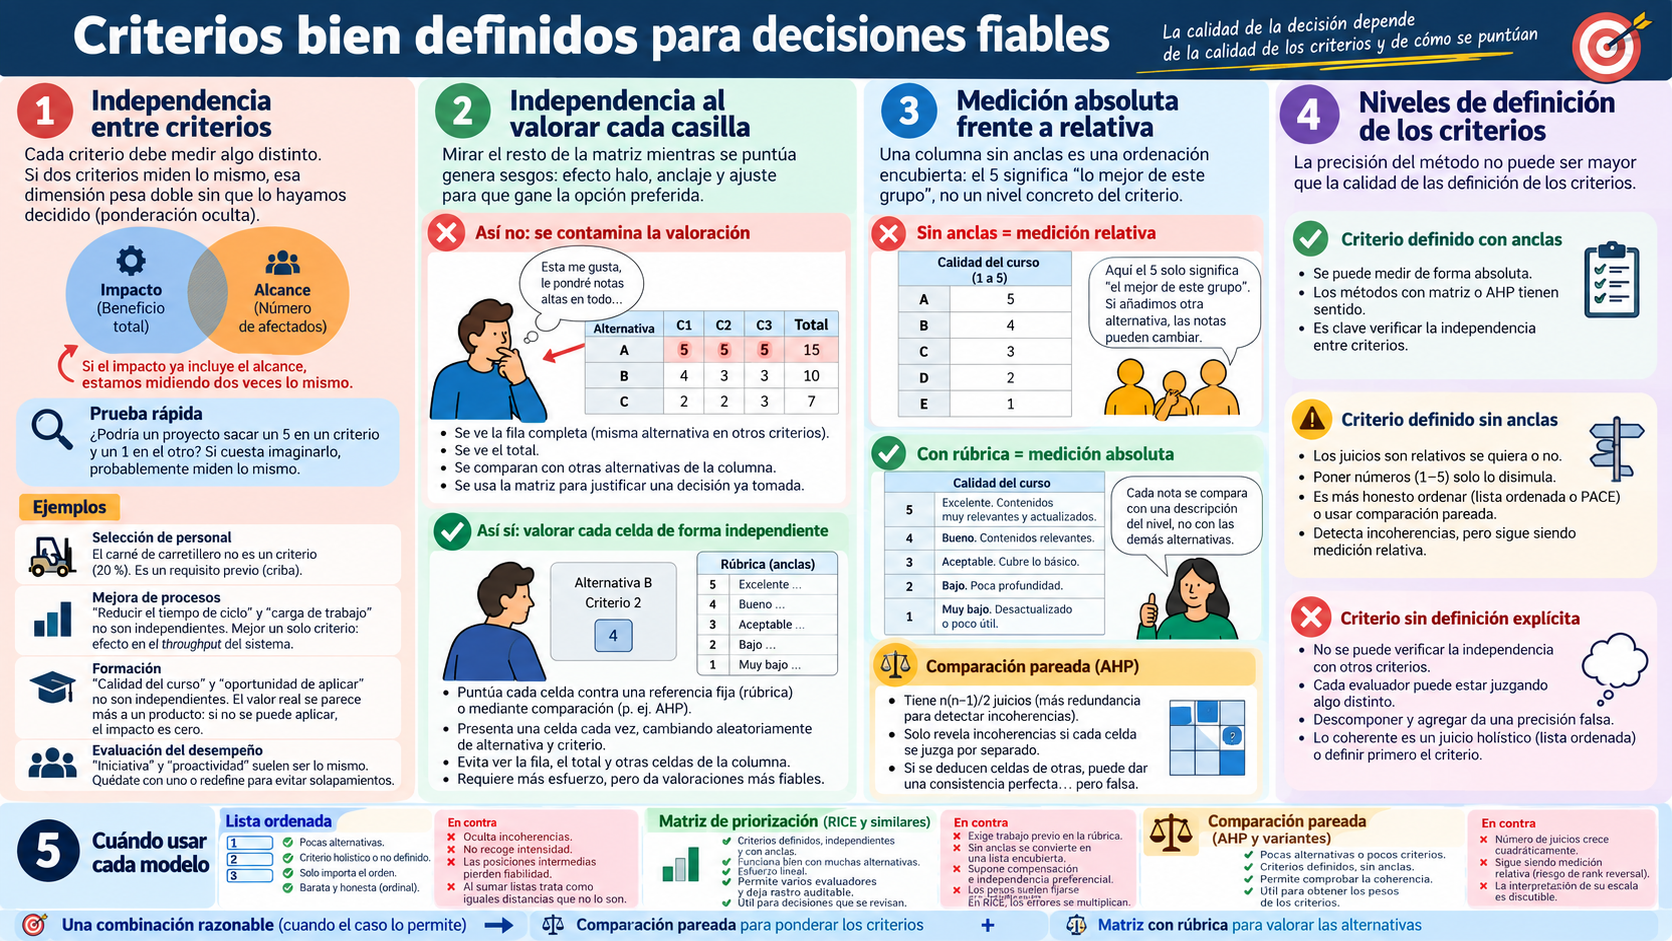
La sofisticación del método no puede superar la calidad de los criterios. Más números no hacen mejor una decisión

criterios de prioraizacion
© Juan A. Marín-García (2026) DOE-UPV-ROGLE-IEMAWith the support of the PIME/25-26/544 [Investigación acción para el diseño de los materiales, protocolo y análisis de viabilidad de una intervención compleja para analizar el impacto en la mejora del pensamiento crítico y el uso del marco de referencia del triple diamante en la toma de decisiones en grupo]. Universitat Politecnica de Valencia.

Más números, más criterios y más cálculos no implican necesariamente una decisión mejor. El rigor consiste en saber qué estamos midiendo, evitar contar dos veces lo mismo, mantener independientes los juicios y utilizar un método coherente con la calidad real de la información disponible.

Errores frecuentes que hacen que una matriz de priorización parezca más rigurosa de lo que realmente es:

  • Duplicar dimensiones sin darse cuenta. Si dos criterios miden aspectos iguales o muy solapados, esa dimensión entra varias veces en la decisión. Es una ponderación oculta.

  • Cuando el valor de un criterio depende del nivel de otro, asignarles pesos separados puede no tener sentido.

  • Confundir criterios con requisitos. Hay condiciones que no deberían recibir un peso ni compensarse con otras. Si algo es imprescindible (por ejemplo, disponer de una habilitación necesaria para un puesto) debe funcionar como filtro o umbral previo, no como una columna más de la matriz.

  • Puntuar viendo la alternativa completa. Cuando el evaluador ve simultáneamente la fila, las demás puntuaciones y, sobre todo, el total, aparecen el efecto halo, el anclaje y los ajustes para que gane la alternativa preferida. La matriz deja entonces de ayudar a tomar la decisión y pasa a justificar una decisión que, consciente o inconscientemente, ya estaba tomada. La unidad de juicio debería ser cada celda, valorada de la forma más independiente posible.

  • Creer que poner números convierte un juicio relativo en una medición absoluta. Una escala 1–5 sin anclas descriptivas no significa necesariamente que “4” represente un nivel objetivo. Con frecuencia significa simplemente “mejor que estas alternativas y peor que aquellas”. Es decir, es una ordenación relativa disfrazada de medición. La medición absoluta requiere una rúbrica que describa qué significa cada nivel.

  • Usar métodos sofisticados con criterios mal definidos. Si “encaje estratégico”, “impacto” o “calidad” significan cosas diferentes para cada evaluador, hacer más cálculos no aumenta la calidad de la decisión. Puede producir justo lo contrario. Genera una falsa rigurosidad, fundamentada en la precisión matemática, que se basa en juicios imprecisos. La sofisticación del método no debería superar la calidad de la definición de los criterios.

  • Desaprovechar la redundancia de la comparación pareada. AHP y otros métodos de comparación pareada de alternativas exigen muchos más juicios precisamente porque esa redundancia permite detectar inconsistencias. Si unas comparaciones se deducen de otras para ahorrar trabajo, puede obtenerse una consistencia aparentemente perfecta, pero se ha eliminado precisamente la información que justificaba realizar las comparaciones adicionales.

  • Elegir el método por su apariencia de rigor y no por el problema de medición. Una lista ordenada puede ser la opción más adecuada cuando el juicio es holístico o los criterios están poco definidos. Una matriz de priorización tiene sentido cuando los criterios están bien definidos, son lo bastante independientes y existen anclas que permitan valorar las alternativas. La comparación pareada resulta especialmente útil cuando los criterios están definidos, pero no existen buenas anclas, y queremos hacer explícitos los juicios relativos y comprobar su coherencia.


caracteristicas de los criterios de priorizacion que condicional técnicas a usar
© Juan A. Marín-García (2026) DOE-UPV-ROGLE-IEMAWith the support of the PIME/25-26/544 [Investigación acción para el diseño de los materiales, protocolo y análisis de viabilidad de una intervención compleja para analizar el impacto en la mejora del pensamiento crítico y el uso del marco de referencia del triple diamante en la toma de decisiones en grupo]. Universitat Politecnica de Valencia.

Universitat Politècnica de ValènciaROGLE, Reengineering Operations GroupWork Logistics Excellence

Visitas: 16

Del primer borrador a la causa raíz: qué suele fallar en un diagrama de 5 porqués

An English version is available here .

El primer error está antes de cualquier porqué. Si un efecto está mal definido, por ejemplo “Tenemos problemas de calidad”, no permite trabajar a nadie. El efecto tiene que poder medirse (qué defecto, en qué línea, cuánto, desde cuándo), porque todo el diagrama se va a contrastar contra él.

En la primera ronda casi siempre salen etiquetas vagas: “molde viejo”, “material malo”. Suenan a causa, pero no se pueden comprobar. La corrección consiste en bajar a la máquina o a los datos y reescribir el posit con algo verificable, lo que se ha visto o lo que dice la ficha técnica. Un posit que no se puede confirmar o descartar no sirve para seguir preguntando.

Con el culpable pasa algo parecido. “Operarios descuidados” o “el técnico no lo conectó” aparecen, y a veces muy abajo, cuando el grupo ya creía haber superado esa fase. Hay una prueba sencilla: si cambiando a la persona el problema seguiría ahí, la causa no es la persona. Se reescribe como conducta observable o como fallo del sistema (la tarea no tiene responsable, nadie enseña otra forma de reaccionar).

Algunas ideas son ciertas, pero responden a otra pregunta. “No se revisan las piezas” explica por qué el defecto llega al cliente, no por qué se produce. No se tira: se deja en espera de decisión, porque merece su propio análisis. Mezclarla con el resto contamina el diagrama. Los posits genéricos que solapan con otra rama (“falta mantenimiento”) se retiran sin más, y lo que tuvieran de cierto acaba saliendo más abajo con palabras concretas.

El error más frecuente, y el más difícil de ver, está en las flechas. Un posit puede estar bien escrito y colgar del sitio equivocado. Ocurre de dos maneras. La primera es poner como hermanas dos causas que en realidad son padre e hijo: subir la presión no está al lado de “presión alta”, la explica, y por eso tiene que bajar un nivel. La segunda es agrupar por tema en lugar de por causalidad. La secadora se pone bajo “material” porque todo lo del material parece ir junto, pero no explica que la fluidez varíe entre lotes. Explica el material húmedo, que está en otra rama y dos niveles más abajo. Cuando se descubre esto, el diagrama no se corrige añadiendo, se corrige moviendo cosas.

También faltan eslabones. Pasar de “el plan cuenta horas, no ciclos” a “desgaste en el molde” parece razonable hasta que se lee despacio: contar horas no desgasta nada. Falta el paso intermedio (el molde supera los ciclos previstos sin revisión), y al intercalarlo todo lo que cuelga debajo baja un nivel.

La herramienta para detectar tanto las flechas mal puestas como los huecos es leer cada rama en voz alta, de abajo arriba, uniendo los posits con “por tanto”. Si alguna frase chirría, ahí hay un problema.

Otro error es pararse demasiado pronto, en la causa técnica: la resistencia de la secadora está rota. Eso se arregla cambiando la resistencia, y la próxima avería volverá a pasar inadvertida. Se sigue preguntando hasta llegar a algo que depende de cómo está organizado el trabajo (las averías de equipos auxiliares no entran en el sistema de gestión de mantenimiento) y que admite una acción concreta con responsable. Ahí se para, y no antes. Por eso hacen falta cinco o seis niveles en las ramas largas, mientras que otras se cierran en tres. No hay que igualarlas.

Personalmente prefiero el formato en gota (“tear drop”) al diagrama de espina de pescado o de Ishikawa, y buena parte de los comentarios anteriores explican por qué. La espina de pescado arranca con categorías fijas (máquina, método, material, mano de obra, medio, medición) y eso empuja justo a agrupar por tema. La secadora acabaría en la espina de “máquina” o en la de “material”, y la relación con el material húmedo, que es lo que importa, quedaría escondida. La categoría “mano de obra” es además una invitación a apuntar culpables. En la gota no hay cajones previos: cada posit cuelga del posit al que explica, y la estructura sale de las relaciones causales, no de una clasificación.

La otra razón es la profundidad. Las espinas de pescado suelen quedarse anchas y planas, con muchas causas en el primer o segundo nivel y pocas cadenas que bajen de ahí, en parte porque en las espinas pequeñas no cabe casi nada. En la gota los niveles se ven: se nota de un vistazo qué rama se ha quedado corta, y el espacio crece hacia abajo justo donde aparecen más causas. Con posits, mover una idea de nivel o cambiarla de flecha es cuestión de segundos, y la lectura de abajo arriba con “por tanto” funciona porque cada cadena es una línea continua. No descarto las categorías del Ishikawa. Cuando un grupo se bloquea en la primera ronda, repasarlas ayuda a que salgan ideas. Las uso como lista de comprobación, no como estructura del diagrama.

Todo esto solo se ve si se acepta que el diagrama no se dibuja de una vez. Lo que sale en la primera media hora es un borrador, y la forma de gota aparece después de reescribir, mover y quitar posits varias veces.

Visitas: 17

From first draft to root cause: what usually goes wrong in a 5 Whys diagram

The first mistake comes before any why: a poorly defined effect. “We have quality problems”, for example, gives nobody anything to work with. The effect has to be measurable (which defect, on which line, how much, since when), because the whole diagram will be checked against it.

The first round almost always produces vague labels: “old mould”, “bad material”. They sound like causes, but they can’t be verified. The fix is to go down to the machine or to the data and rewrite the sticky note with something verifiable, whether it’s what was seen or what the process sheet says. A note that can’t be confirmed or ruled out is no use for asking the next why.

Something similar happens with blame. “Careless operators” or “the technician didn’t connect it” show up, sometimes far down the diagram, when the group thought it had moved past that stage. There is a simple test: if the problem would still be there with a different person, the cause isn’t the person. The note is rewritten as observable behaviour or as a failure of the system (the task has no owner, nobody teaches another way to react).

Some ideas are true but answer a different question. “Parts aren’t inspected” explains why the defect reaches the customer, not why it happens. It isn’t thrown away. It goes to “awaiting decision”, because it deserves its own analysis. Mixing it in with the rest contaminates the diagram. Generic notes that overlap with another branch (“lack of maintenance”) are simply removed, and whatever truth they held ends up surfacing further down in concrete terms.

The most frequent mistake, and the hardest to spot, is in the arrows. A note can be well written and hang from the wrong place. This happens in two ways. The first is placing two causes side by side as siblings when they are really parent and child: raising the pressure doesn’t sit next to “high pressure”, it explains it, so it has to drop a level. The second is grouping by topic instead of by causality. The dryer gets placed under “material” because everything about material seems to belong together, but it doesn’t explain why the flow index varies between batches. It explains the damp material, which is in another branch and two levels further down. When this comes to light, the diagram isn’t corrected by adding things. It’s corrected by moving them.

Links go missing too. Going from “the plan counts hours, not cycles” to “wear on the mould” seems reasonable until you read it slowly: counting hours doesn’t wear anything. The intermediate step is missing (the mould exceeds its planned cycles without inspection). Once it’s inserted, everything hanging below it drops a level.

The tool for catching both misplaced arrows and gaps is to read each branch aloud, bottom-up, joining the notes with “therefore”. If any sentence grates, there’s a problem there.

Another mistake is stopping too early, at the technical cause: the dryer’s heating element is broken. That gets fixed by replacing the element, and the next breakdown will go unnoticed again. You keep asking until you reach something that depends on how the work is organised (failures on auxiliary equipment aren’t logged in the maintenance management system) and that allows a concrete action with an owner. That’s where you stop, and not before. This is why the long branches need five or six levels while others close at three. There’s no need to even them out.

Personally, I prefer the tear drop format to the fishbone or Ishikawa diagram, and many of the mistakes above explain why. The fishbone starts from fixed categories (machine, method, material, manpower, environment, measurement), and that pushes people towards exactly the grouping by topic described above. The dryer would end up on the “machine” or the “material” bone, and its link to the damp material, which is what matters, would stay hidden. The “manpower” category is also an open invitation to write down culprits. In the tear drop there are no predefined boxes: each note hangs from the note it explains, and the structure comes from causal relationships, not from a classification.

The other reason is depth. Fishbone diagrams tend to end up wide and flat, with many causes on the first or second level and few chains going further. Part of the reason is that the small bones have almost no room. In the tear drop the levels are visible. You can see at a glance which branch has stopped short, and the space grows downwards precisely where more causes appear. With sticky notes, moving an idea to another level or another arrow takes seconds, and reading bottom-up with “therefore” works because each chain is a single continuous line. I don’t discard the Ishikawa categories. When a group gets stuck in the first round, going through them helps ideas come out. I use them as a checklist, not as the structure of the diagram.

None of this becomes visible unless you accept that the diagram isn’t drawn in one go. What comes out in the first half hour is a draft, and the tear drop shape emerges only after rewriting, moving and removing notes several times.

Visitas: 3

Empieza a aparecer una red de concepciones alternativas

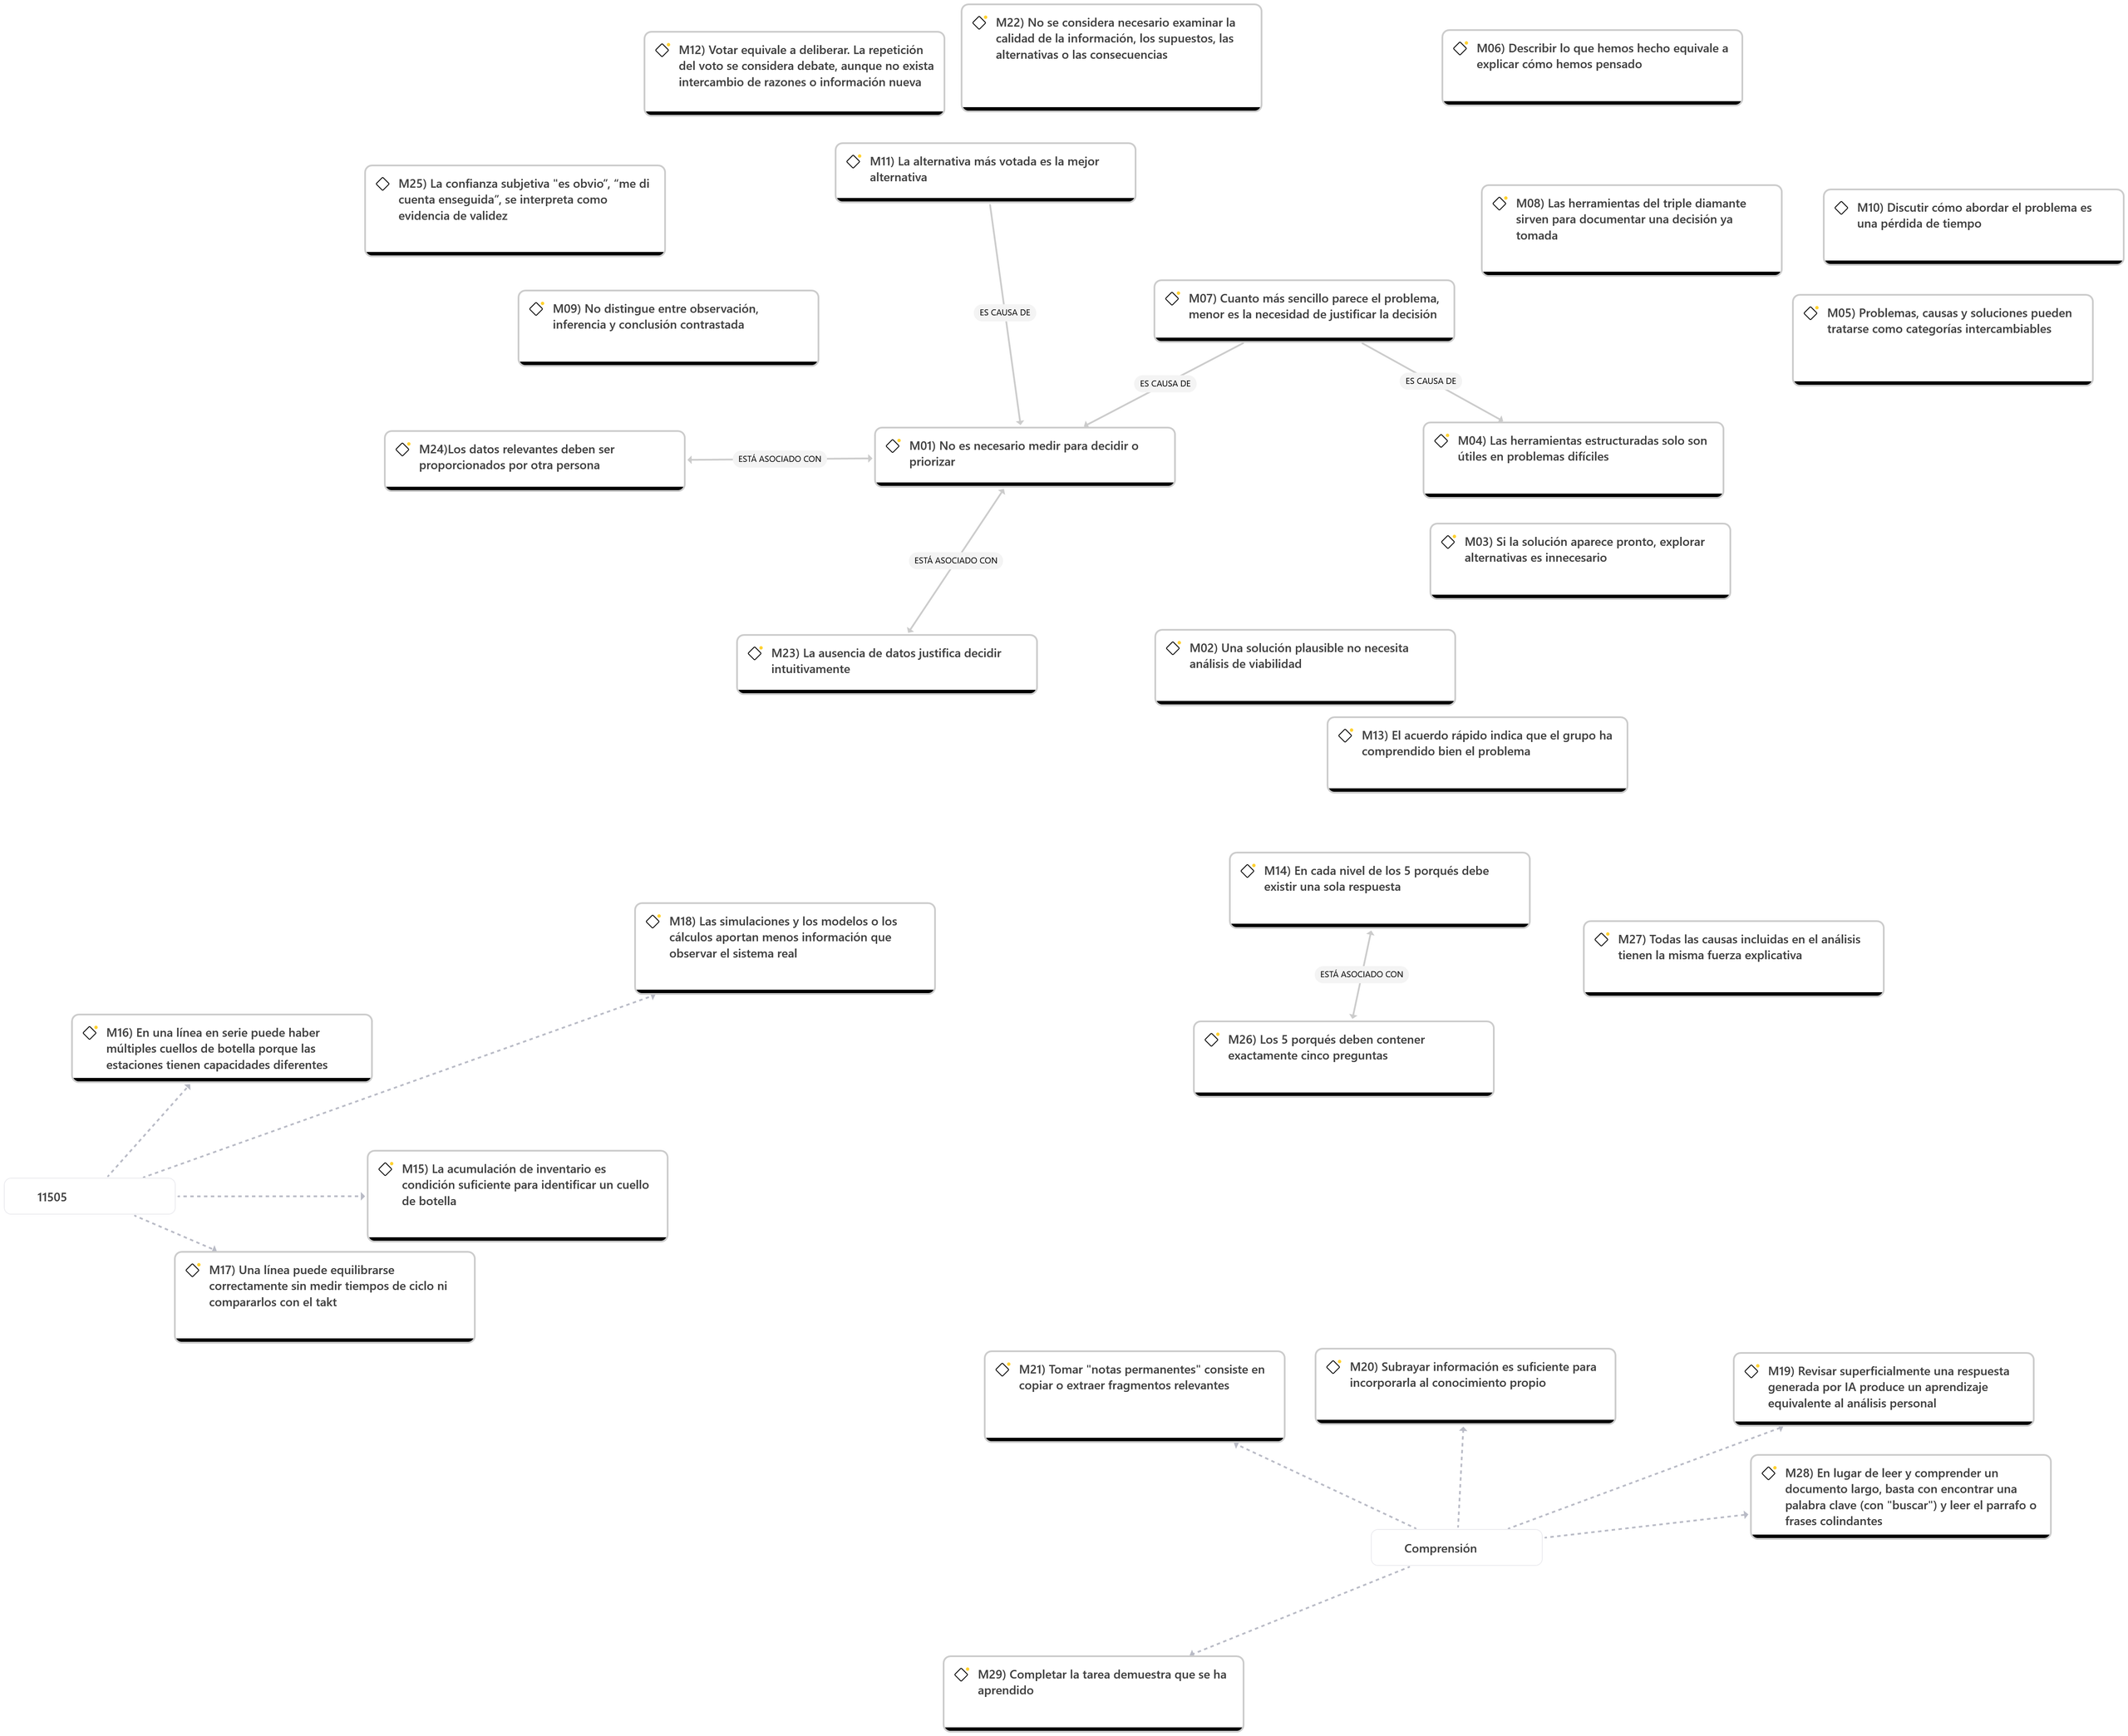
Durante el curso 2025-26 hemos ido observando qué ocurre mientras nuestros-as estudiantes resuelven casos en clase, cuando intentan utilizar el Triple Diamante, para analizar problemas, identificar causas, priorizar alternativas o justificar una decisión. El resultado provisional es una red de 29 concepciones alternativas. Esta red parte únicamente de la observación no participante en vivo (nos falta aún analizar las reflexiones posteriores a la tarea que han realizado los-as estudiantes por escrito).

Muchas de esas concepciones son atajos que parecen funcionar en determinados contextos. Sin embargo, aunque no sean conscientes, la “calidad” de sus soluciones queda mermada por esas concepciones y, en otros contextos, acaban creando una trampa en la que las soluciones se ven  sesgadas y, en muchas ocasiones, resultan inadecuadas.

En esta primera agrupación , hemos creado un núcleo que tiene que ver con los datos y las evidencias. Aparecen concepciones como que no es necesario medir para decidir, que si no tenemos datos podemos decidir intuitivamente, que alguien debería proporcionarnos los datos que necesitamos (aunque podríamos estimarlos, no lo hacemos) o que expresiones como “es obvio” o “me di cuenta enseguida” son suficiente garantía de que una conclusión es correcta. Relacionada con esto está la dificultad para distinguir entre hechos, inferencias, opiniones y percepciones.

Un segundo núcleo tiene que ver con cerrar el proceso de decisión demasiado pronto. Si aparece rápidamente una solución plausible, ¿para qué seguir explorando? Si todo el grupo está de acuerdo, ¿para qué buscar otras perspectivas? Si el problema parece sencillo, ¿para qué utilizar herramientas estructuradas? En esta lógica, el Triple Diamante corre el riesgo de convertirse en una forma de documentar una decisión que ya estaba tomada, en lugar de ser una ayuda para construirla.

También aparece un tercer bloque relacionado con el proceso de toma de decisiones en grupo. Por ejemplo, asumir que la alternativa más votada es necesariamente la mejor o que votar equivale a deliberar. Pero hacer estadística con las preferencias del grupo no es lo mismo que compartir información, confrontar argumentos y permitir que las personas cambien su punto de vista.

Otra agrupación aparece alrededor del procedimiento de análisis: confundir la identificación de problemas, sus causas y las alternativas de solución; interpretar los 5 porqués como una cadena obligatoriamente lineal, o asumir que todas las causas identificadas tienen la misma fuerza o impacto.

Hemos creado un último grupo relacionado con procesos de comprensión, aprendizaje (cómo emerge el conocimiento implícito y como se transoforma en explícito para poder ser gestionado en el grupo): considerar que revisar superficialmente una respuesta generada por IA equivale a analizar personalmente un problema, que subrayar es suficiente para incorporar conocimiento, que localizar una palabra clave con la función de busqueda en un “PDF” sustituye a leer y comprender un documento o, sencillamente, que haber completado una tarea demuestra que se ha aprendido o se domina un proceso.

Una interpretación provisional es que, detrás de muchas de estas concepciones, emerge una tendencia a evitar hacer explícito nuestro razonamiento. Si algo parece evidente, si encontramos pronto una solución o si el grupo alcanza rápidamente un acuerdo, dejamos de medir, contrastar, explorar alternativas o explicar por qué hemos llegado a esa conclusión.

Si esta interpretación se confirma, enseñar pensamiento crítico no consistirá solo en explicar mejor las herramientas. Tendremos que diseñar situaciones que hagan visible el razonamiento implícito, pidiéndoles evidencias, que contrasten inferencias alternativas, que trabajen con datos incompletos, y que se pregunten ¿por qué? 

La idea es utilizar “thinking aloud” para descubrir qué está ocurriendo mientras se toma la decisión y comprobar si eso, además, les ayuda a tomar conciencia de sus concepciones y cambiarlas.


Visitas: 12

Por qué hace falta saber mucho para poder cuestionar bien

#IAgenerativa #PIME_DECIDE #docencia #evidenciasdeaprendizaje

Llevamos un año trabajando en el PIME_DECIDE (DECIDE – Design and Evaluation of Collaborative Intervention for Decision Enhancement | Blog de Juan A. Marin-Garcia) y este artículo me ha inspirado algunas ideas para poner en práctica.

Bini, G., & Quattrociocchi, W. (2026). Epistemia in the classroom: The problem of evidence of understanding in education in the age of generative AI. AI And Society. https://doi.org/10.1007/s00146-026-03227-y

Tenemos un listado provisional de 21 concepciones alternativas detectadas. Tres se conectan directamente con este artículo:

  1. Revisar superficialmente una respuesta generada por IA produce un aprendizaje equivalente al análisis personal
  2. Subrayar información es suficiente para incorporarla al conocimiento propio
  3. Tomar notas consiste principalmente en copiar o extraer fragmentos relevantes

Damos por hecho que alguien ha entendido cuando lo que dice suena bien. Eso pasaba mucho antes de que existiera la IA generativa (es un caso documentado por Erlwanger desde los años setenta). Se trata de una tendencia cognitiva anclada en mecanismos reforzados a lo largo de todo el proceso evolutivo de la especie humana.

Un fragmento que nos resulta muy útil es este:

“these interventions point towards a shift from the production of texts to their critical interrogation, understood as the ability to question claims, test arguments, compare frameworks, identify limits, confront outputs with independently grounded knowledge, and ultimately assume responsibility for what is asserted.” (Bini y Quattrociocchi, 2026, p. 9)

Este será el objetivo de la observación participante en directo en los grupos para poder capturar el proceso. 

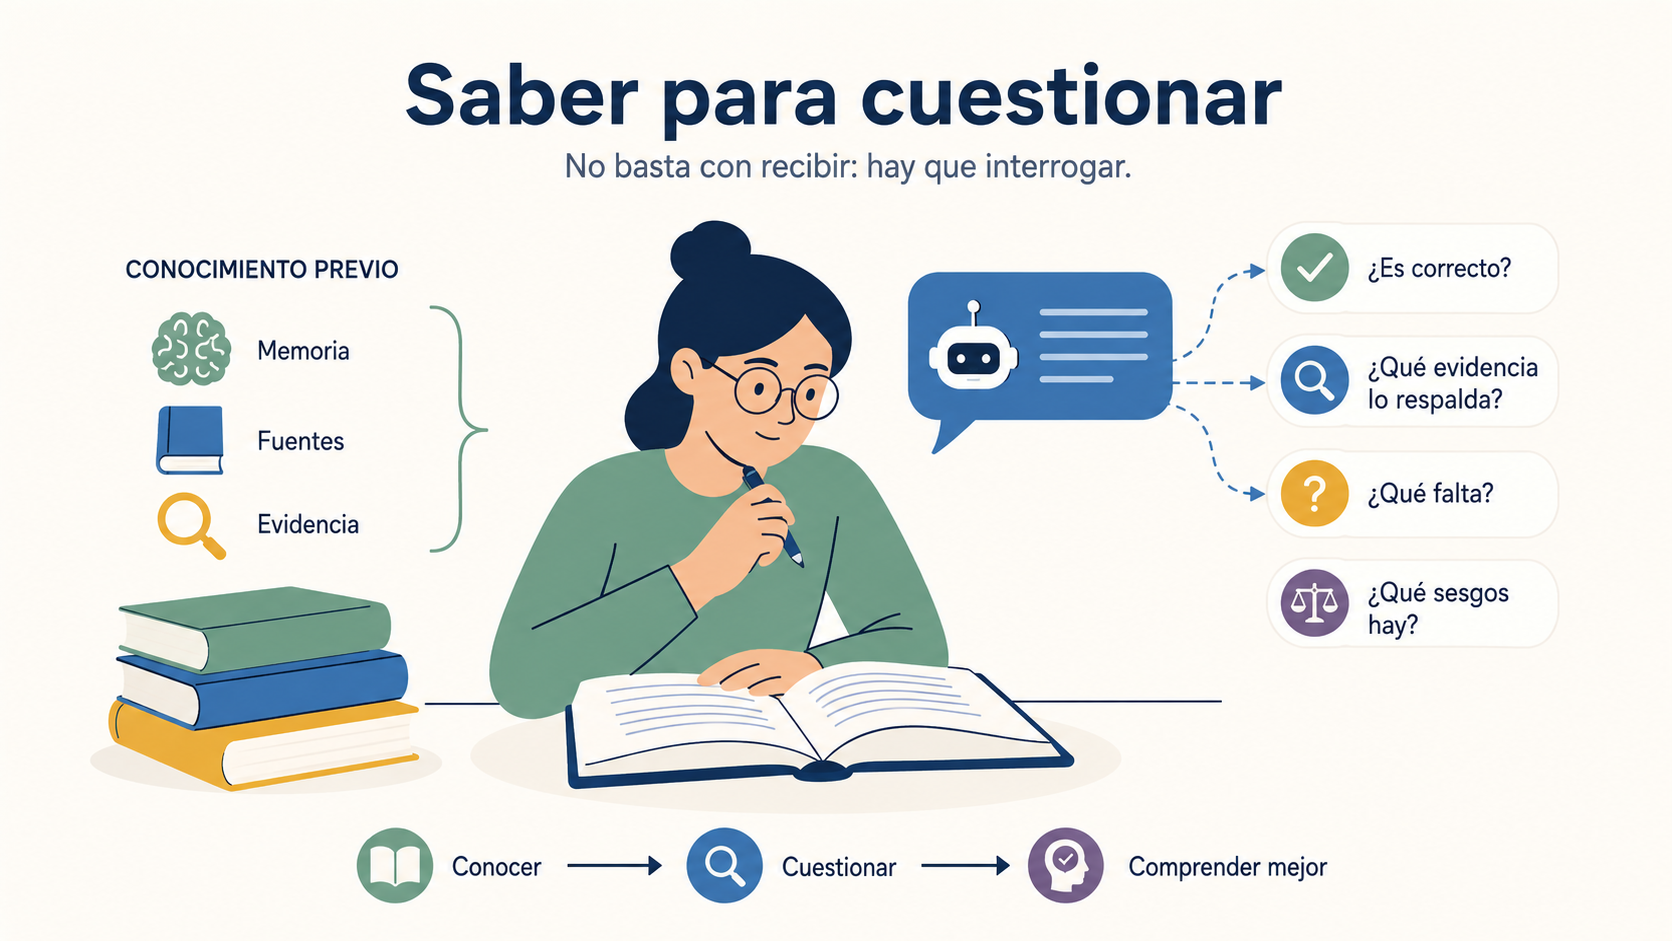
Cuestionar algo solo es posible si ya tienes una base de conocimiento suficiente y familiaridad con las fuentes para reconocer referencias con sentido, formular preguntas y detectar lo que falta. Que es justo lo contrario de lo que se asume cuando se dice que con la IA ya no hace falta saber porque todo el conocimiento está accesible en los chats. Cuanto más parece que el sistema reduce la necesidad de producir conocimiento por tu cuenta, más se necesita ese conocimiento para ser usado críticamente. El saber no desaparece; se recoloca como recurso para cuestionar en vez de ser un fin en sí mismo (no es reproducción, es comprensión, pero para comprender necesitas tener una memoria a largo plazo densamente poblada). Esto me viene bien para reforzar los argumentos sobre qué es aprender, que llevo repitiendo en varios foros y charlas durante el último año.

El objetivo del PIME-DECIDE es fomentar el pensamiento experto basado en evidencia en las personas graduadas en Ingeniería de Organización. Medir eso es complicado y aún no contamos con un instrumento fiable. Mientras, usaremos soluciones provisionales para ir informando del progreso, con las limitaciones que eso implica y asumiendo que habrá que tirar a la basura alguna de esas soluciones en el futuro.

El artículo  es una contribución teórica, y sus autores lo dicen abiertamente. Una de las cosas que piden es precisamente comprobar si las intervenciones que hacen visible cómo se genera el producto y guían su cuestionamiento logran fomentar el aprendizaje. Eso es más o menos lo que vamos a intentar en el PIME-DECIDE el próximo curso 2026-27.

Visitas: 10

Los LLMs no recuerdan (las personas tampoco): estrategias para trabajar con memoria limitada

Mis “take away”  de la lectura de esta entrada de blog de Ethan Mollick:

  1. Los LLM son aduladores y lisonjeros por naturaleza, tienes que pedirles que sean críticos o “destructivos” para intentar que hagan análisis más ecuánimes. Pero nunca tendrás la seguridad de que te detecten todos los errores o te manifiesten abiertamente todas las cosas negativas, sobre todo si están analizando una propuesta que es un bodrio sideral
  2. Los LLM no tienen memoria a largo plazo. Cada plataforma tiene estrategias distintas para lidiar con el problema de superar la ventana de contexto. ChatGPT usa un FIFO (que, si estás conversando de manera iterativa profundizando sobre el mismo concepto, te da buen resultado porque realmente lo que importa es lo último en lo que estás trabajando). Claude hace “borrón y cuenta nueva”, pero antes, cuando detecta que se queda sin contexto, compacta la conversación (y la documentación subida), la guarda, inicia una nueva instancia y coge como punto de partida el resumen y, a partir de ahí, empieza a trabajar de nuevo. La forma en que trabaja CLAUDE es exactamente el modo que yo trabajo cuando tengo tareas con tiempo fragmentado (Que no puedo completar en una sesión de trabajo), por eso supongo que me gustan más los resultados que me da Claude que los de ChatGPT
  3. Además de lo anterior, el uso de Skills y Agents permite aliviar el problema de la memoria de contexto. Solo se activa lo que necesitas para una tarea y, además, puedes activar “hilos” en paralelo (cada uno con su propia memoria de contexto libre para ese hilo) que se comunican entre sí (los resultados de unos son las entradas para otros). Es una forma modular y analítica de resolver tareas (algo que yo también hago de manera natural: divido en subtareas que me caben en tiempo fragmentado y guardo la “preparación” intermedia para alimentar otras tareas)


He tenido que rebuscar un poco para clarificar los conceptos de skill y agent, este es mi resumen:

  • Skill (instrucciones/prompts y herramientas para realizar una tarea concreta)
    • Instrucción: descripción de cuándo usar el skill (ej. “Usa esto cuando la usuaria pregunte por X”)
    • Herramienta: un trozo de código, una API o una función (ej. buscar en Google, calcular una hipoteca)
  • Agent (deciden (razonar, planificar) qué herramienta usar, en qué orden las usan y qué hacer si algo sale mal). Puedes activar varios agentes en paralelo
    • Sigue un ciclo o un proceso: Analiza la meta: “¿Qué me han pedido?”; Planifica: “¿Qué pasos necesito y qué Skills debo usar?”; Ejecuta: Usa una Skill; Observa: “¿El resultado es lo que esperaba?”; Itera: Repite hasta terminar
Imagen generada con Gemini nano banana
Imagen generada con ChatGPT5.2

Visitas: 20

Reflexion sobre tecnologia

He leído varios blogs estos días donde me ha parecido que sus autoras-es se quejaban de que los “copilotos IA” están mal diseñados y que son los culpables de todos los malos usos que se les están dando. Igual no es lo que querían decir, pero es el mensaje que me ha calado.

Esto me ha llevado a dos reflexiones:

  1. Mejor llamarle herramienta porque no es un copiloto, por mucho que sus desarrolladores quieran denominarlo así porque vende mejor o más
  2. El problema no es del “copiloto”. El problema es del piloto. Si el piloto decide estrellar el barco contra el iceberg, no es problema del barco ni del iceberg. Las tecnologías no son «neutras», eso es cierto, pero el uso (o no uso) que decide darles cada persona es lo que determina el impacto.

Visitas: 6

Hechos, inferencias, opiniones y percepciones (no es todo lo mismo)

Como diría Alejandro Sanz, no es lo mismo. Por mucho que en el día a día, en las conversaciones o en las decisiones, eso que llamamos “la gente” (que no deja de ser un eufemismo para evitar reconocer que “la gente”, como hacienda, somos todos) parece querer convencernos, y convencerse, de que sus opiniones son inferencias basadas en hechos, cuando son solo opiniones.

Como estas tres palabras representan claramente cosas distintas, voy a detallar en esta entrada qué son y dar algunos ejemplos de cada una, para intentar, en la medida de lo posible, que en el futuro llamemos a las cosas por su nombre, evitando considerarlas como sinónimos.

Hechos

Un hecho es una afirmación que describe algo que ha ocurrido o está ocurriendo. Los hechos pueden comprobarse mediante observación directa, medición, documentación o evidencia empírica, de modo que son verificables de manera objetiva e independiente de las opiniones (o de la persona que observa el hecho). De modo que diferentes observadores pueden llegar al mismo resultado al porque describen “qué es” o “qué pasó”, y no “qué debería ser” o “qué les gustaría que fuera”.

Ejemplos de hechos: “la temperatura es de 25°C”, “María tiene 30 años”, “el experimento produjo 50ml de solución”, “la empresa tuvo pérdidas de 1 millón de euros en 2024”.

Inferencias

Las inferencias son conclusiones lógicas que se derivan de hechos (evidencias, datos o premisas disponibles) mediante un proceso de razonamiento. Las inferencias pueden evaluarse y resultar correctas o incorrectas. Su validez depende de la calidad del razonamiento y de la (veracidad) de las evidencias o premisas usadas en el razonamiento.

Por ejemplo: “si llueve, las calles estarán mojadas” o “como las ventas disminuyeron un 30% este trimestre, probablemente necesitamos revisar nuestra estrategia de marketing”.

Debemos tener en cuenta que los hechos pueden interpretarse de diferentes maneras. Es decir, podemos extraer diferentes inferencias. El hecho “Las ventas bajaron un 30%” es verificable, pero las interpretaciones sobre por qué bajaron (“fue por la mala estrategia de marketing”) ya son una inferencia que debe contrastarse adicionalmente (no basta que el hecho sea verificado y cierto para que la inferencia lo sea).

Opiniones

Las opiniones son juicios de valor o puntos de vista personales que reflejan preferencias, creencias, sentimientos o valoraciones subjetivas. Las opiniones están influidas por experiencias personales, valores, cultura y emociones. Pueden ser válidas para quien las expresa, pero no pueden demostrarse como verdaderas o falsas de manera objetiva.

Por ejemplo: “esta clase es aburrida”, “el lean es mejor que la Gestión de Operaciones tradicional”, o “deberíamos invertir más en formación de empleados”. 

Percepciones

Interpretaciones subjetivas e inmediatas de la realidad, filtradas por nuestros sentidos, experiencias y marcos mentales. A diferencia de los hechos, dos personas pueden tener percepciones distintas del mismo evento. A diferencia de las opiniones, no siempre son juicios de valor conscientes. A diferencia de las inferencias, no requieren razonamiento deliberado.

La clave está en reconocer que “yo percibo X” no significa que X sea un hecho, pero tampoco invalida la experiencia de quien percibe.

Visitas: 132

¿Te da miedo que la IA sea mejor que tus estudiantes? A mí no

He comparado la respuesta de Claude-sonnet-4 y las de 4 grupos de estudiantes de máster (5 personas en cada grupo) con un caso que he preparado como diagnóstico inicial para comprobar las competencias de mis estudiantes el primer día de clase.

Mis estudiantes han estado trabajando 2 horas sobre un caso de 5 páginas donde su tarea estaba descrita en un párrafo y el resto era información de contextualización.

El Prompt usado con Claude-sonnet-4 en poe.com era simplemente el párrafo de descripción de la tarea a realizar sin ningún contexto adicional (ni de nivel de estudios, ni de contexto… nada). 

“resuelve este caso “”Formas parte de un proyecto que pretende alinear el uso de Inteligencia Artificial (IA) con los valores y objetivos estratégicos de la UPV, de modo que la IA ayude a construir
en lugar de minar el futuro que queremos ser.
Como grupo, debéis manifestar vuestro punto de vista, como estudiantes universitarios,
sobre cómo percibís la IAgen, explorar los problemas o inquietudes que os genera en los
diferentes usos o funciones en las que os afecta como estudiantes en la universidad y
clasificarlos/filtrarlos. Para acabar proponiendo un listado de recomendaciones (o guías)
de uso que sugerís para resolver las causas que originan los problemas que consideráis
como principales y un plan para la implementación de esas recomendaciones.”””

Todos los grupos de estudiantes, en lugar de hacer unas guías para estudiantes, han hecho recomendaciones para la universidad o sus equipos directivos. Claude-sonnet-4 ha cometido exactamente el mismo error en la primera iteración. No obstante, su informe ha sido mucho mejor que el de cualquiera de los grupos.

Le he pedido a la IA una segunda iteración: “las recomendaciones que has dado son para la institución, no has respetado la tarea que era crear recomendaciones para los estudiantes. Por otra parte, ajusta el reporte al modelo triple diamante”. En este caso ha clavado las recomendaciones, aunque su interpretación de lo que era el “framework” de triple diamante dejaba mucho que desear, pero le hubiera puesto un 5 o un 6 de nota a ese ejercicio (los ejercicios de mis estudiantes no creo que pasen de un 2 o un 3, pero a ellos no les he dado la oportunidad de repetirlo).

Conclusión:

Cuando les pido a mis estudiantes, a PRINCIPIO de curso que resuelvan un caso y les valoro en base a los resultados de aprendizaje que esperaría que tuvieran a FINAL de curso, la IA generativa les da “mil vueltas” (o por lo menos una decena).

Lo interesante aquí es qué pasará al final del curso cuando mis estudiantes hayan superado los resultados de aprendizaje esperados. La IA generativa no mejorará su nota de 5-6 (salvo que estemos ante un nuevo modelo), entonces creo que serán mis estudiantes los que le darán mil vueltas a la IA generativa.

Visitas: 37